使用参考图生成新画面时,最常见的问题不是“模型没看懂”,而是“模型看得太多”。你原本只想借用参考图的机位和人物位置,模型却把颜色、服装、材质、光线甚至画风一并带进了结果。文字提示写得越多,各种要求之间还可能互相争夺控制权。
解决这类问题的关键,是把参考素材拆成不同职责:角色图负责人物身份和服装,风格图负责色彩与质感,深度图负责远近、轮廓与空间关系、动作。到了视频生成中,深度视频还能继续提供人物移动、遮挡变化和镜头运动的线索。每份素材只控制一个主要变量,模型更容易知道“什么要保留,什么要重新设计”。
不过,深度图经常被口语化地叫作“灰模”。这个叫法方便,却容易让人误以为只要把图片变成黑白,或者生成一张灰色的三维效果图,就能得到同样的控制。本节先把概念讲清,再给出可以直接使用的图片与视频提示词。
一、深度图到底是什么
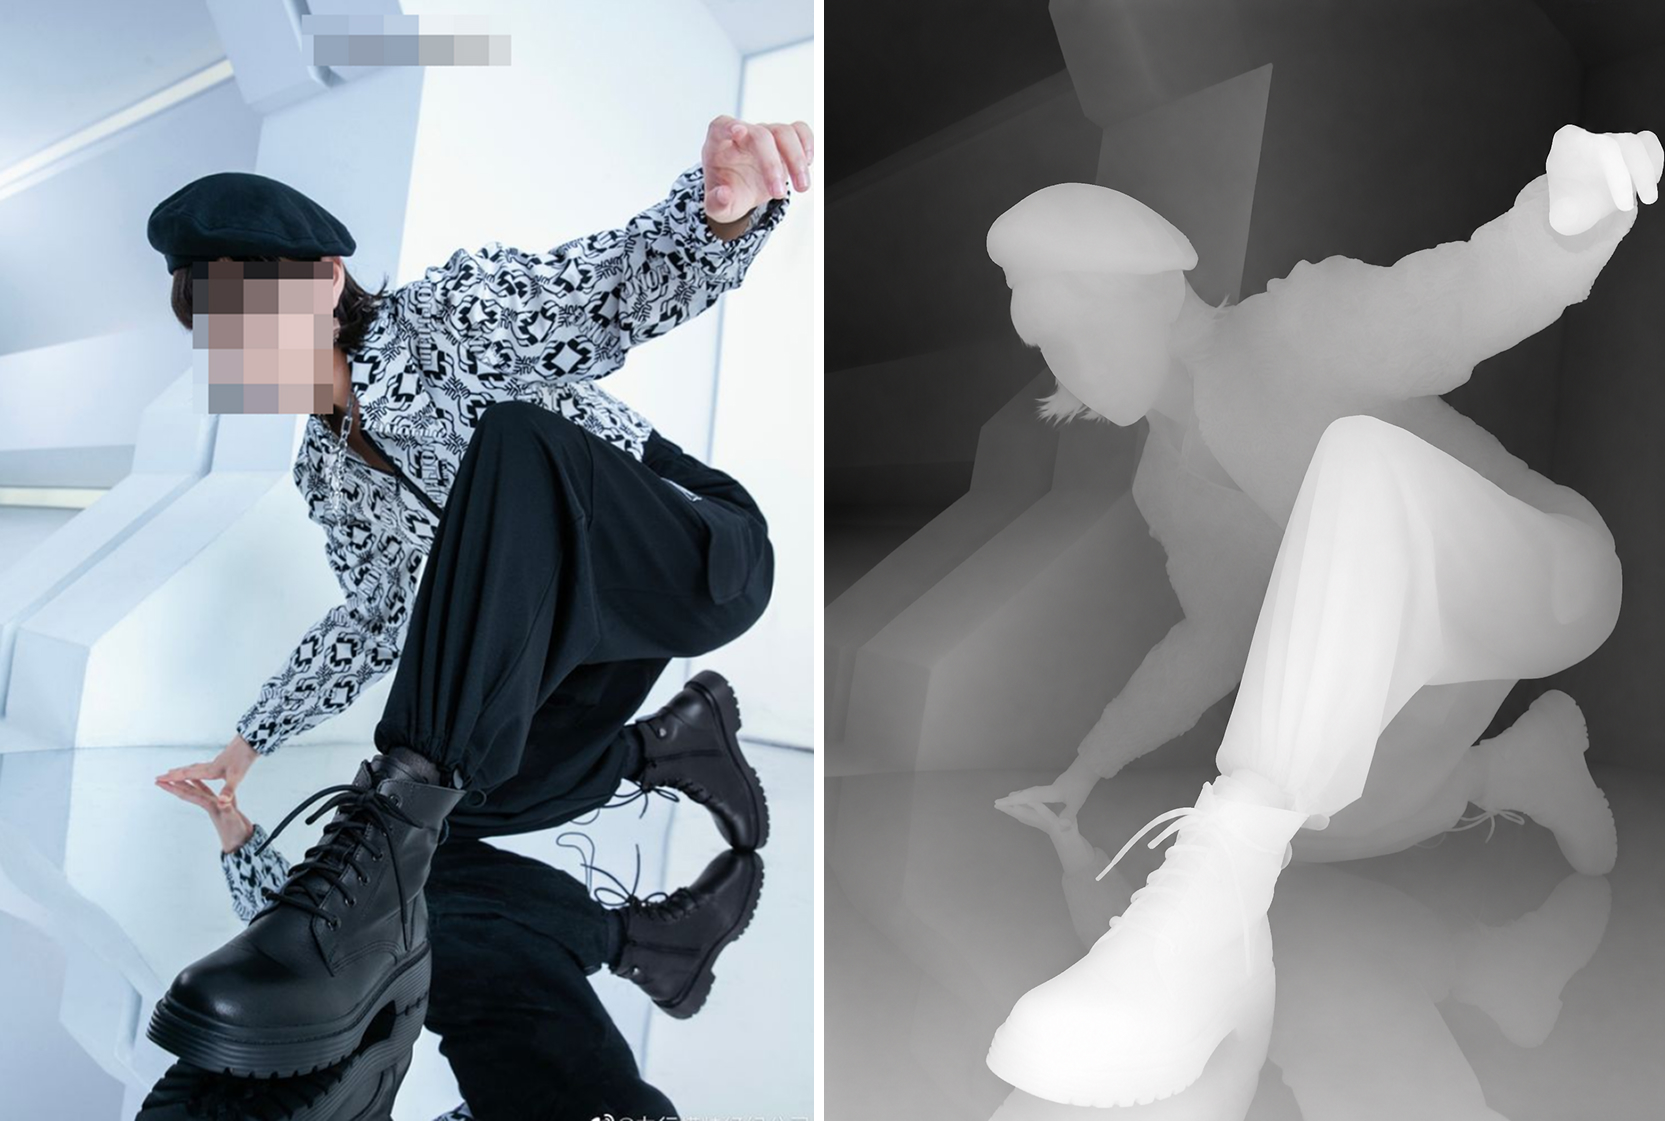
深度图是一张记录画面远近关系的二维图。它的每个像素不再主要描述颜色,而是用不同数值表示该位置相对镜头的距离。为了便于观看,这些数值常被显示成黑、白、灰:一种常见约定是近处较白、远处较黑,也有工具使用相反规则。因此,使用前一定要确认当前工具的黑白方向,不能只凭肉眼猜测。
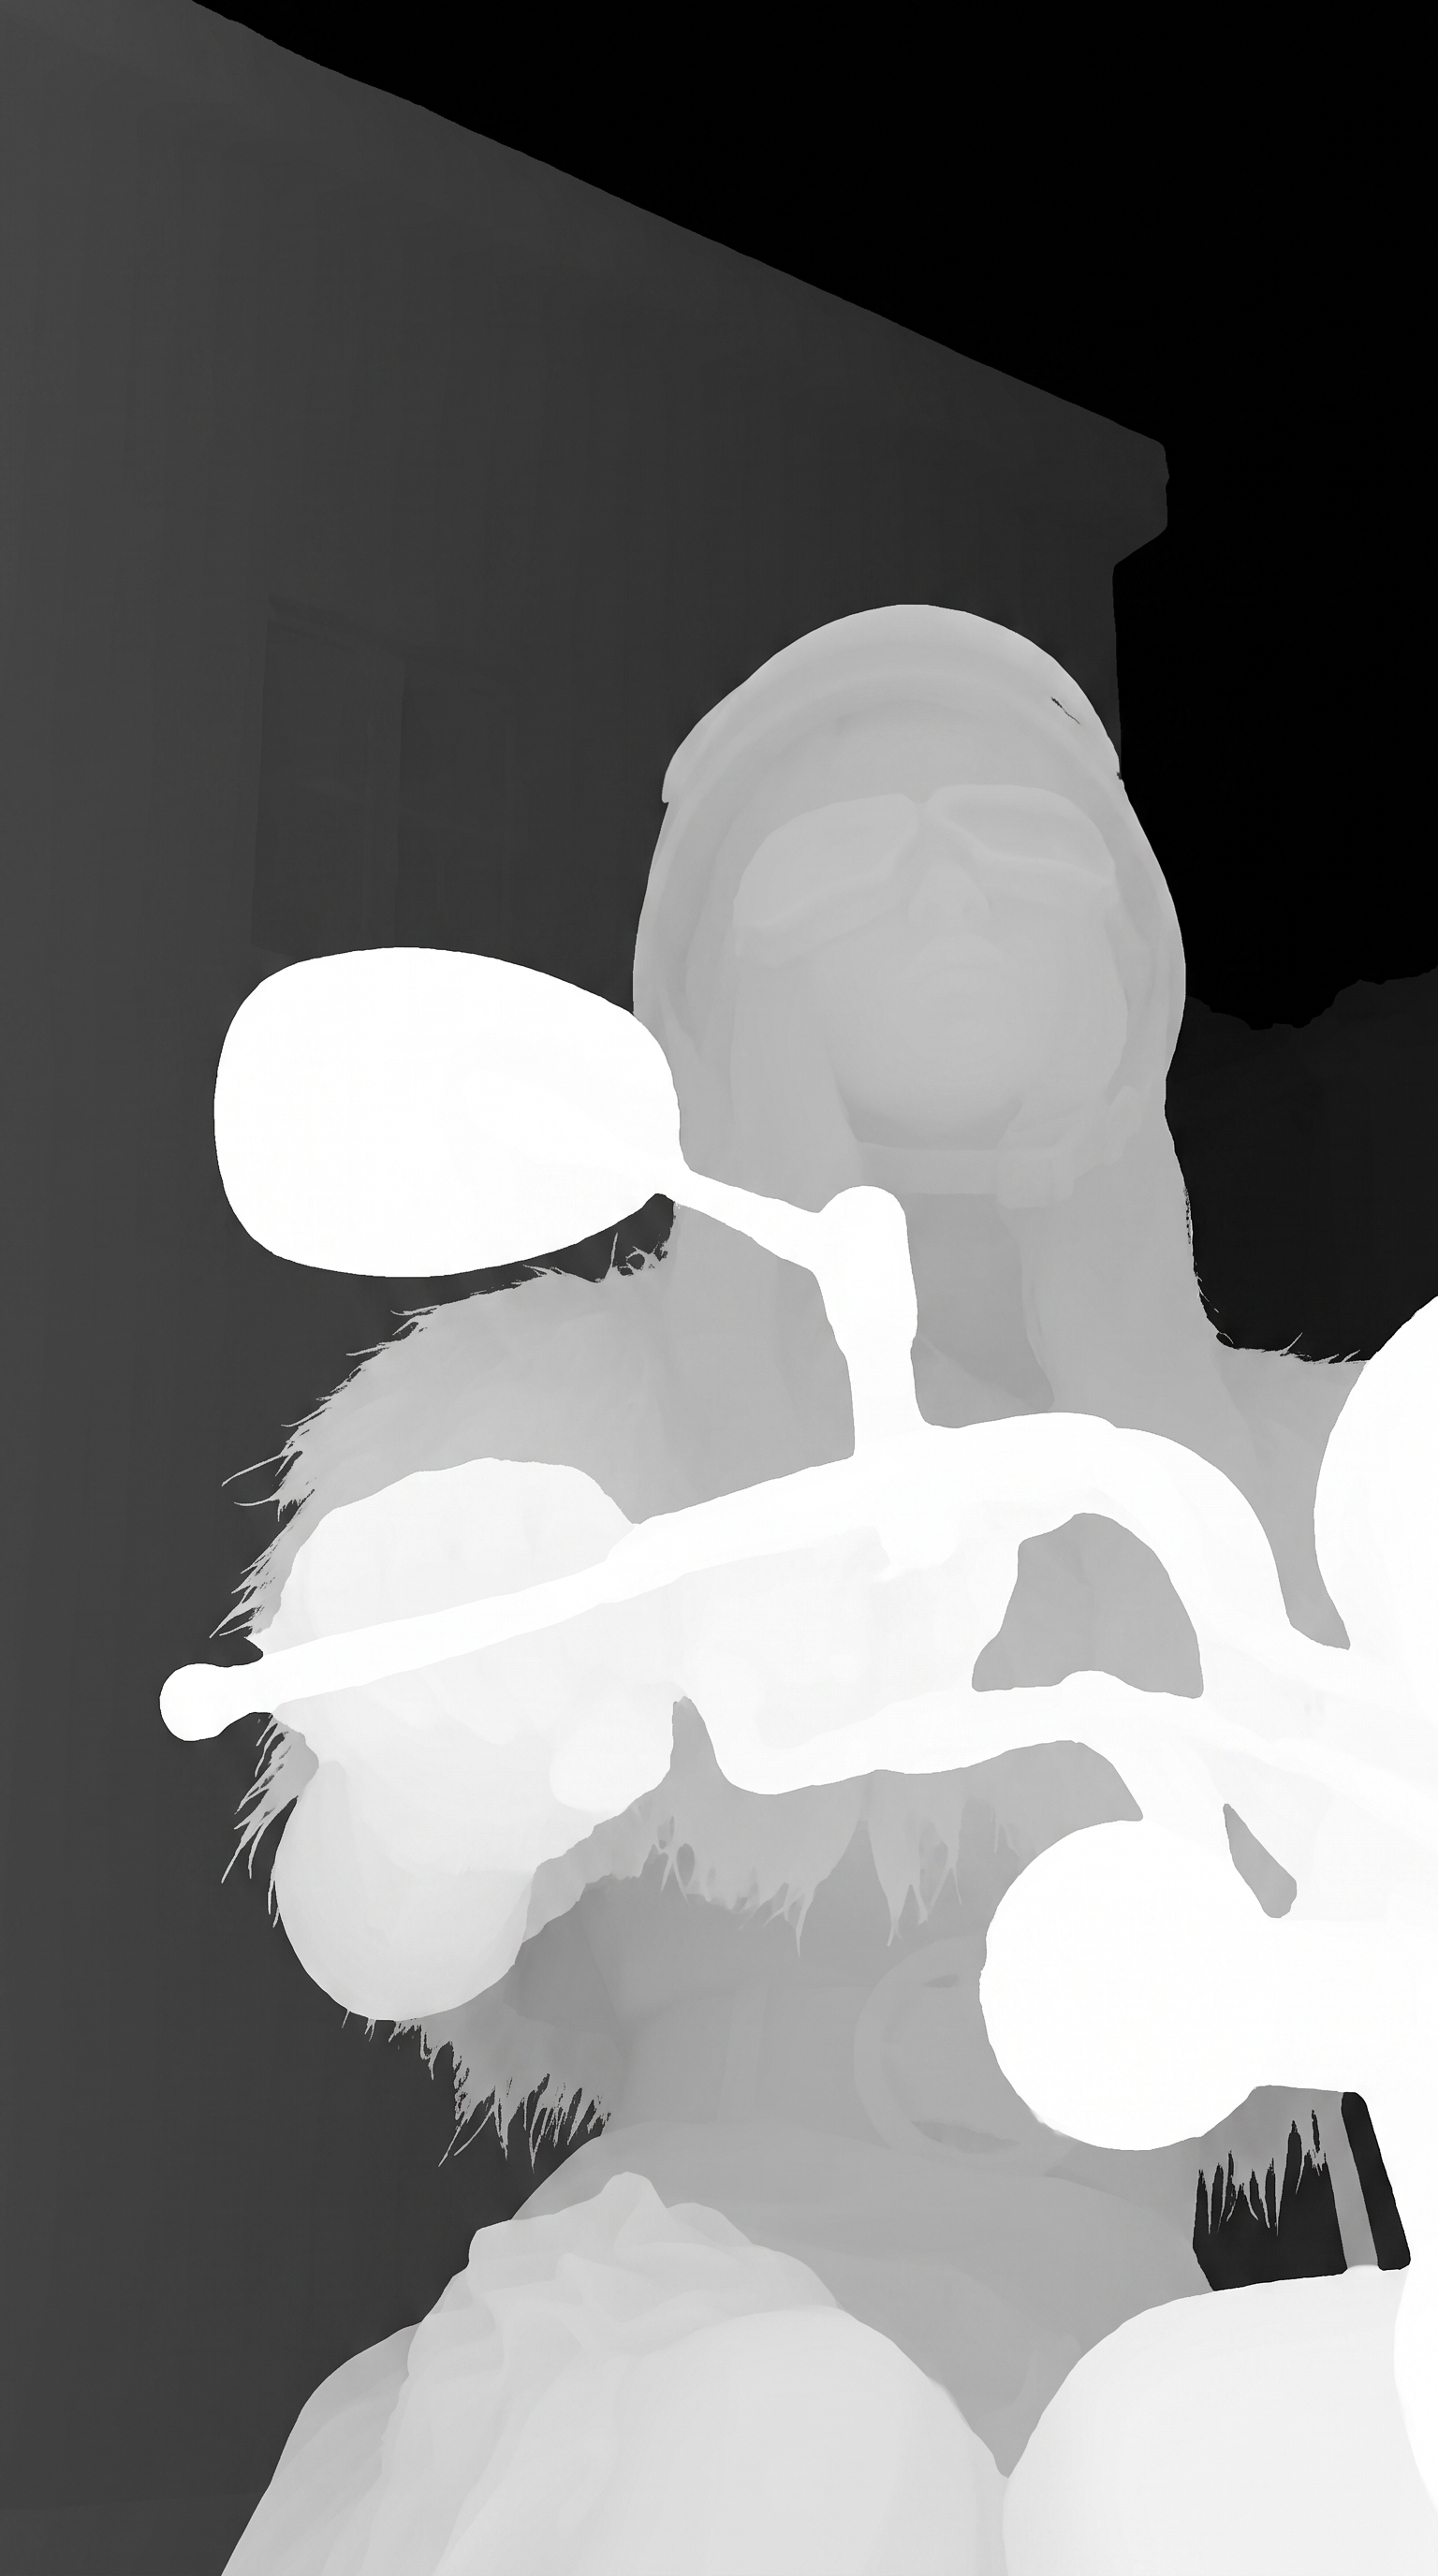
例图
从单张普通照片推测深度,叫作“单目深度估计”。“单目”就是只看一个镜头。由于输入没有真实距离数据,模型通常依靠透视、遮挡、物体大小和已有视觉经验来推测前后关系。得到的结果多半是“相对深度”:它能判断谁更近、谁更远,却不一定知道人物距离镜头究竟是1.5米还是2米。
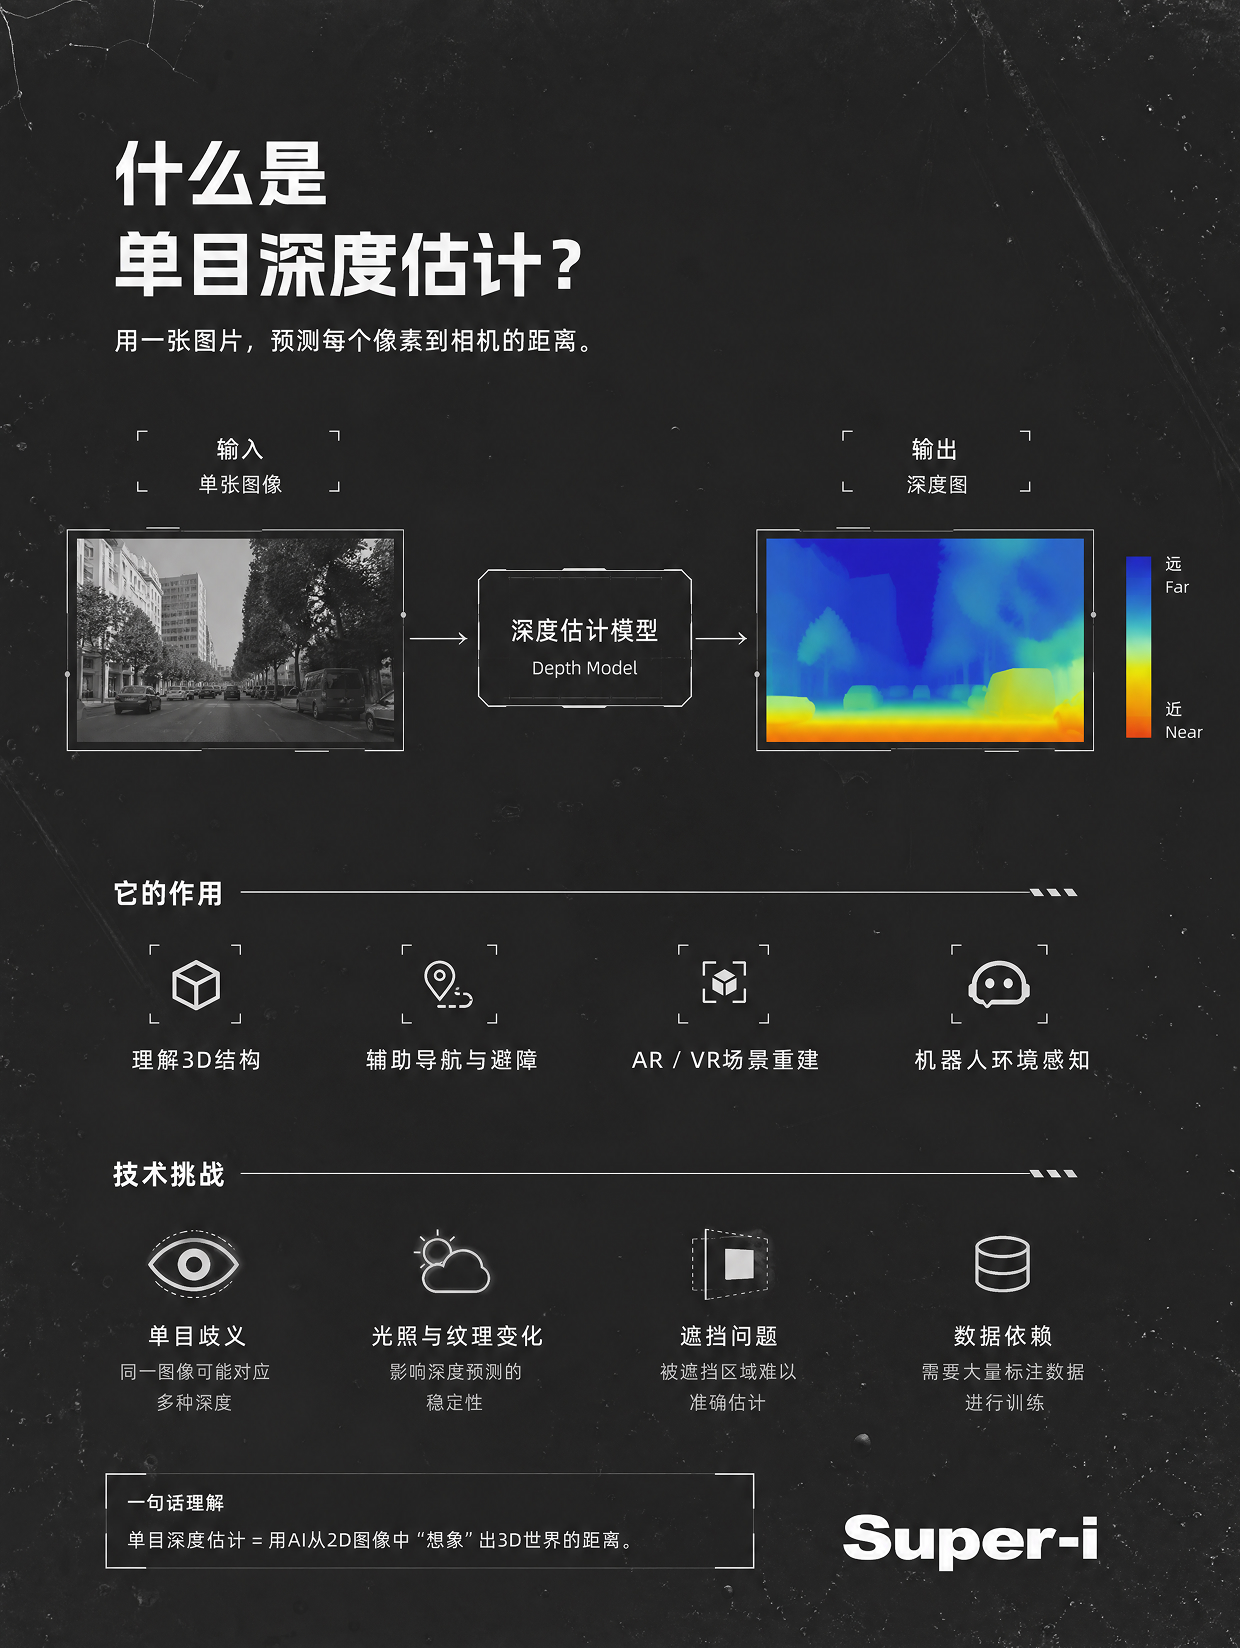
这也是深度图适合创作控制、却不能冒充精密测量的原因。它能够把画面压缩成一种更干净的结构提示,帮助生成模型关注:
- 主体在画面中的位置与大小;
- 前景、中景、背景的层次;
- 人物与道具之间的遮挡关系;
- 镜头高低、远近和透视带来的空间感;
- 视频中这些关系随时间发生的变化。
深度图通常不会可靠保留人物身份、服装花纹、材质、颜色和光线气氛。这恰好是它的价值:只传递结构,不让原图风格占据全部控制权。
二、灰度图、灰模和深度图不是一回事
灰度图
只是去掉颜色,原画面的明暗仍然存在。白衣服可能很亮,黑头发可能很暗,但这种明暗并不等于远近。把彩色照片直接“去色”,不能得到深度图。
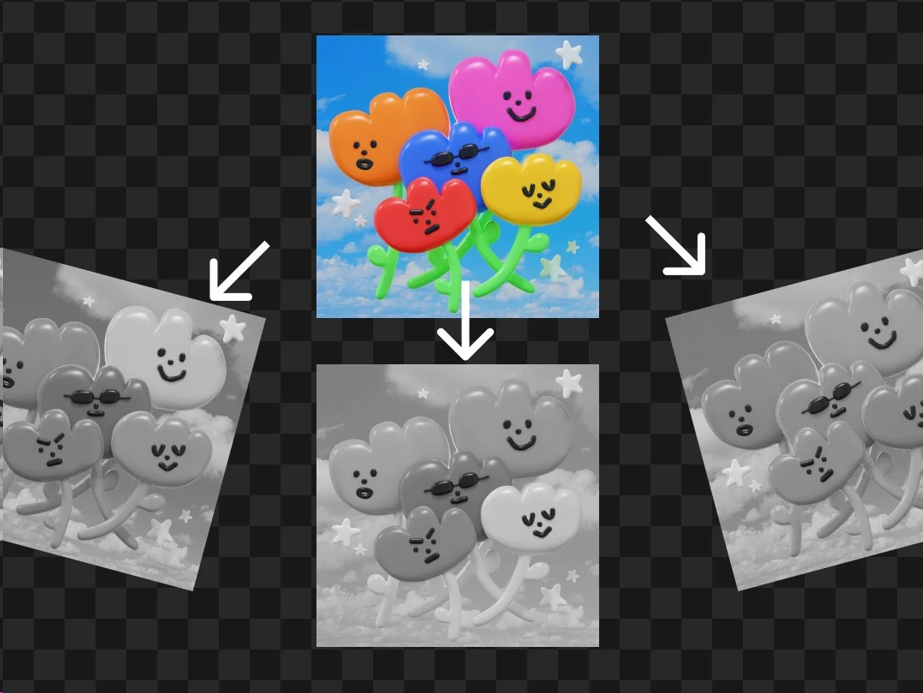
灰度图
灰模
通常指三维制作中的中性材质预览:模型、场景和灯光还在,只是暂时不使用最终贴图与材质。它适合检查造型、体块和照明,但它仍然是一张被渲染出来的画面,不是逐像素记录距离的数据。
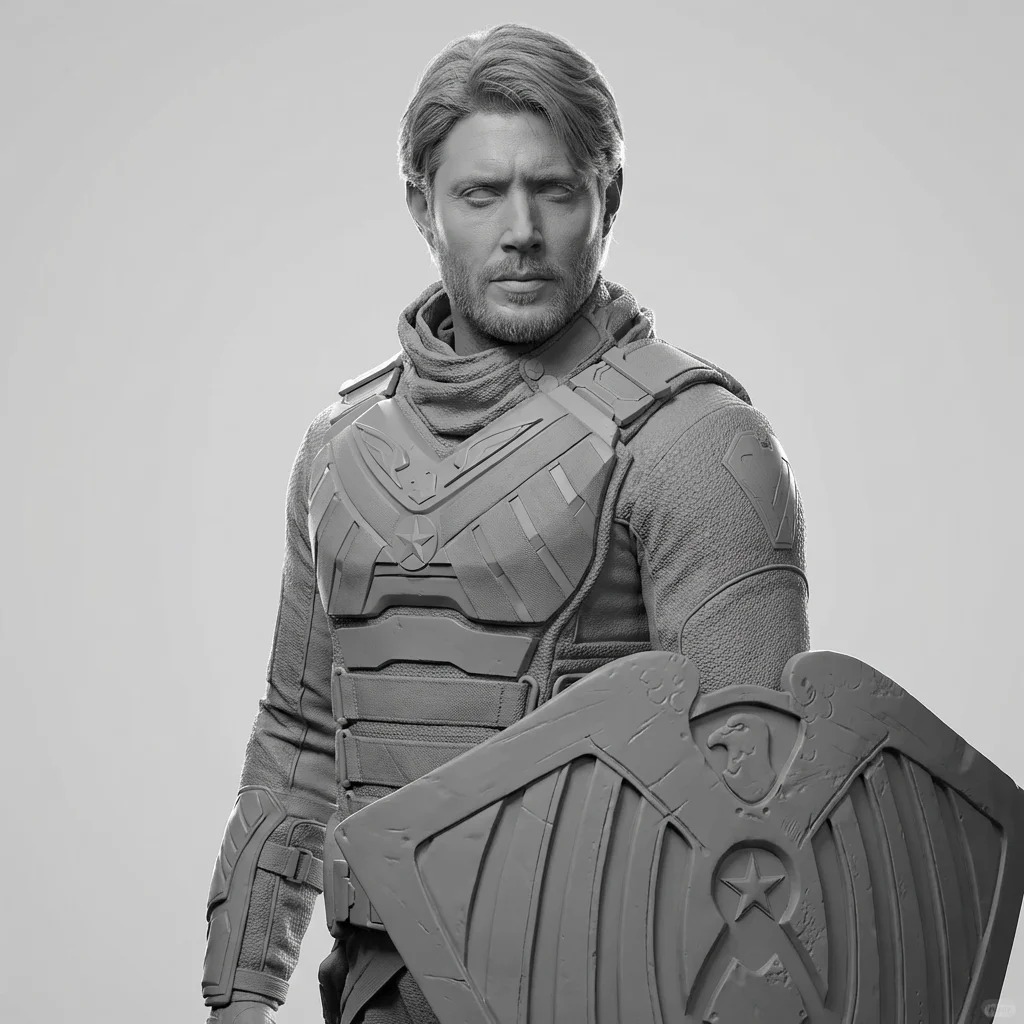
深度图
则是空间距离的可视化。同一个人的脸、衣服和身体只要处于接近的距离,通常会呈现相近的灰度;身后的墙面则会落到另一段灰度范围。准确的说法应当是“生成单目相对深度图”或“把视频转换为连续深度序列”,而不是只说“做成灰色”或“生成灰模”。
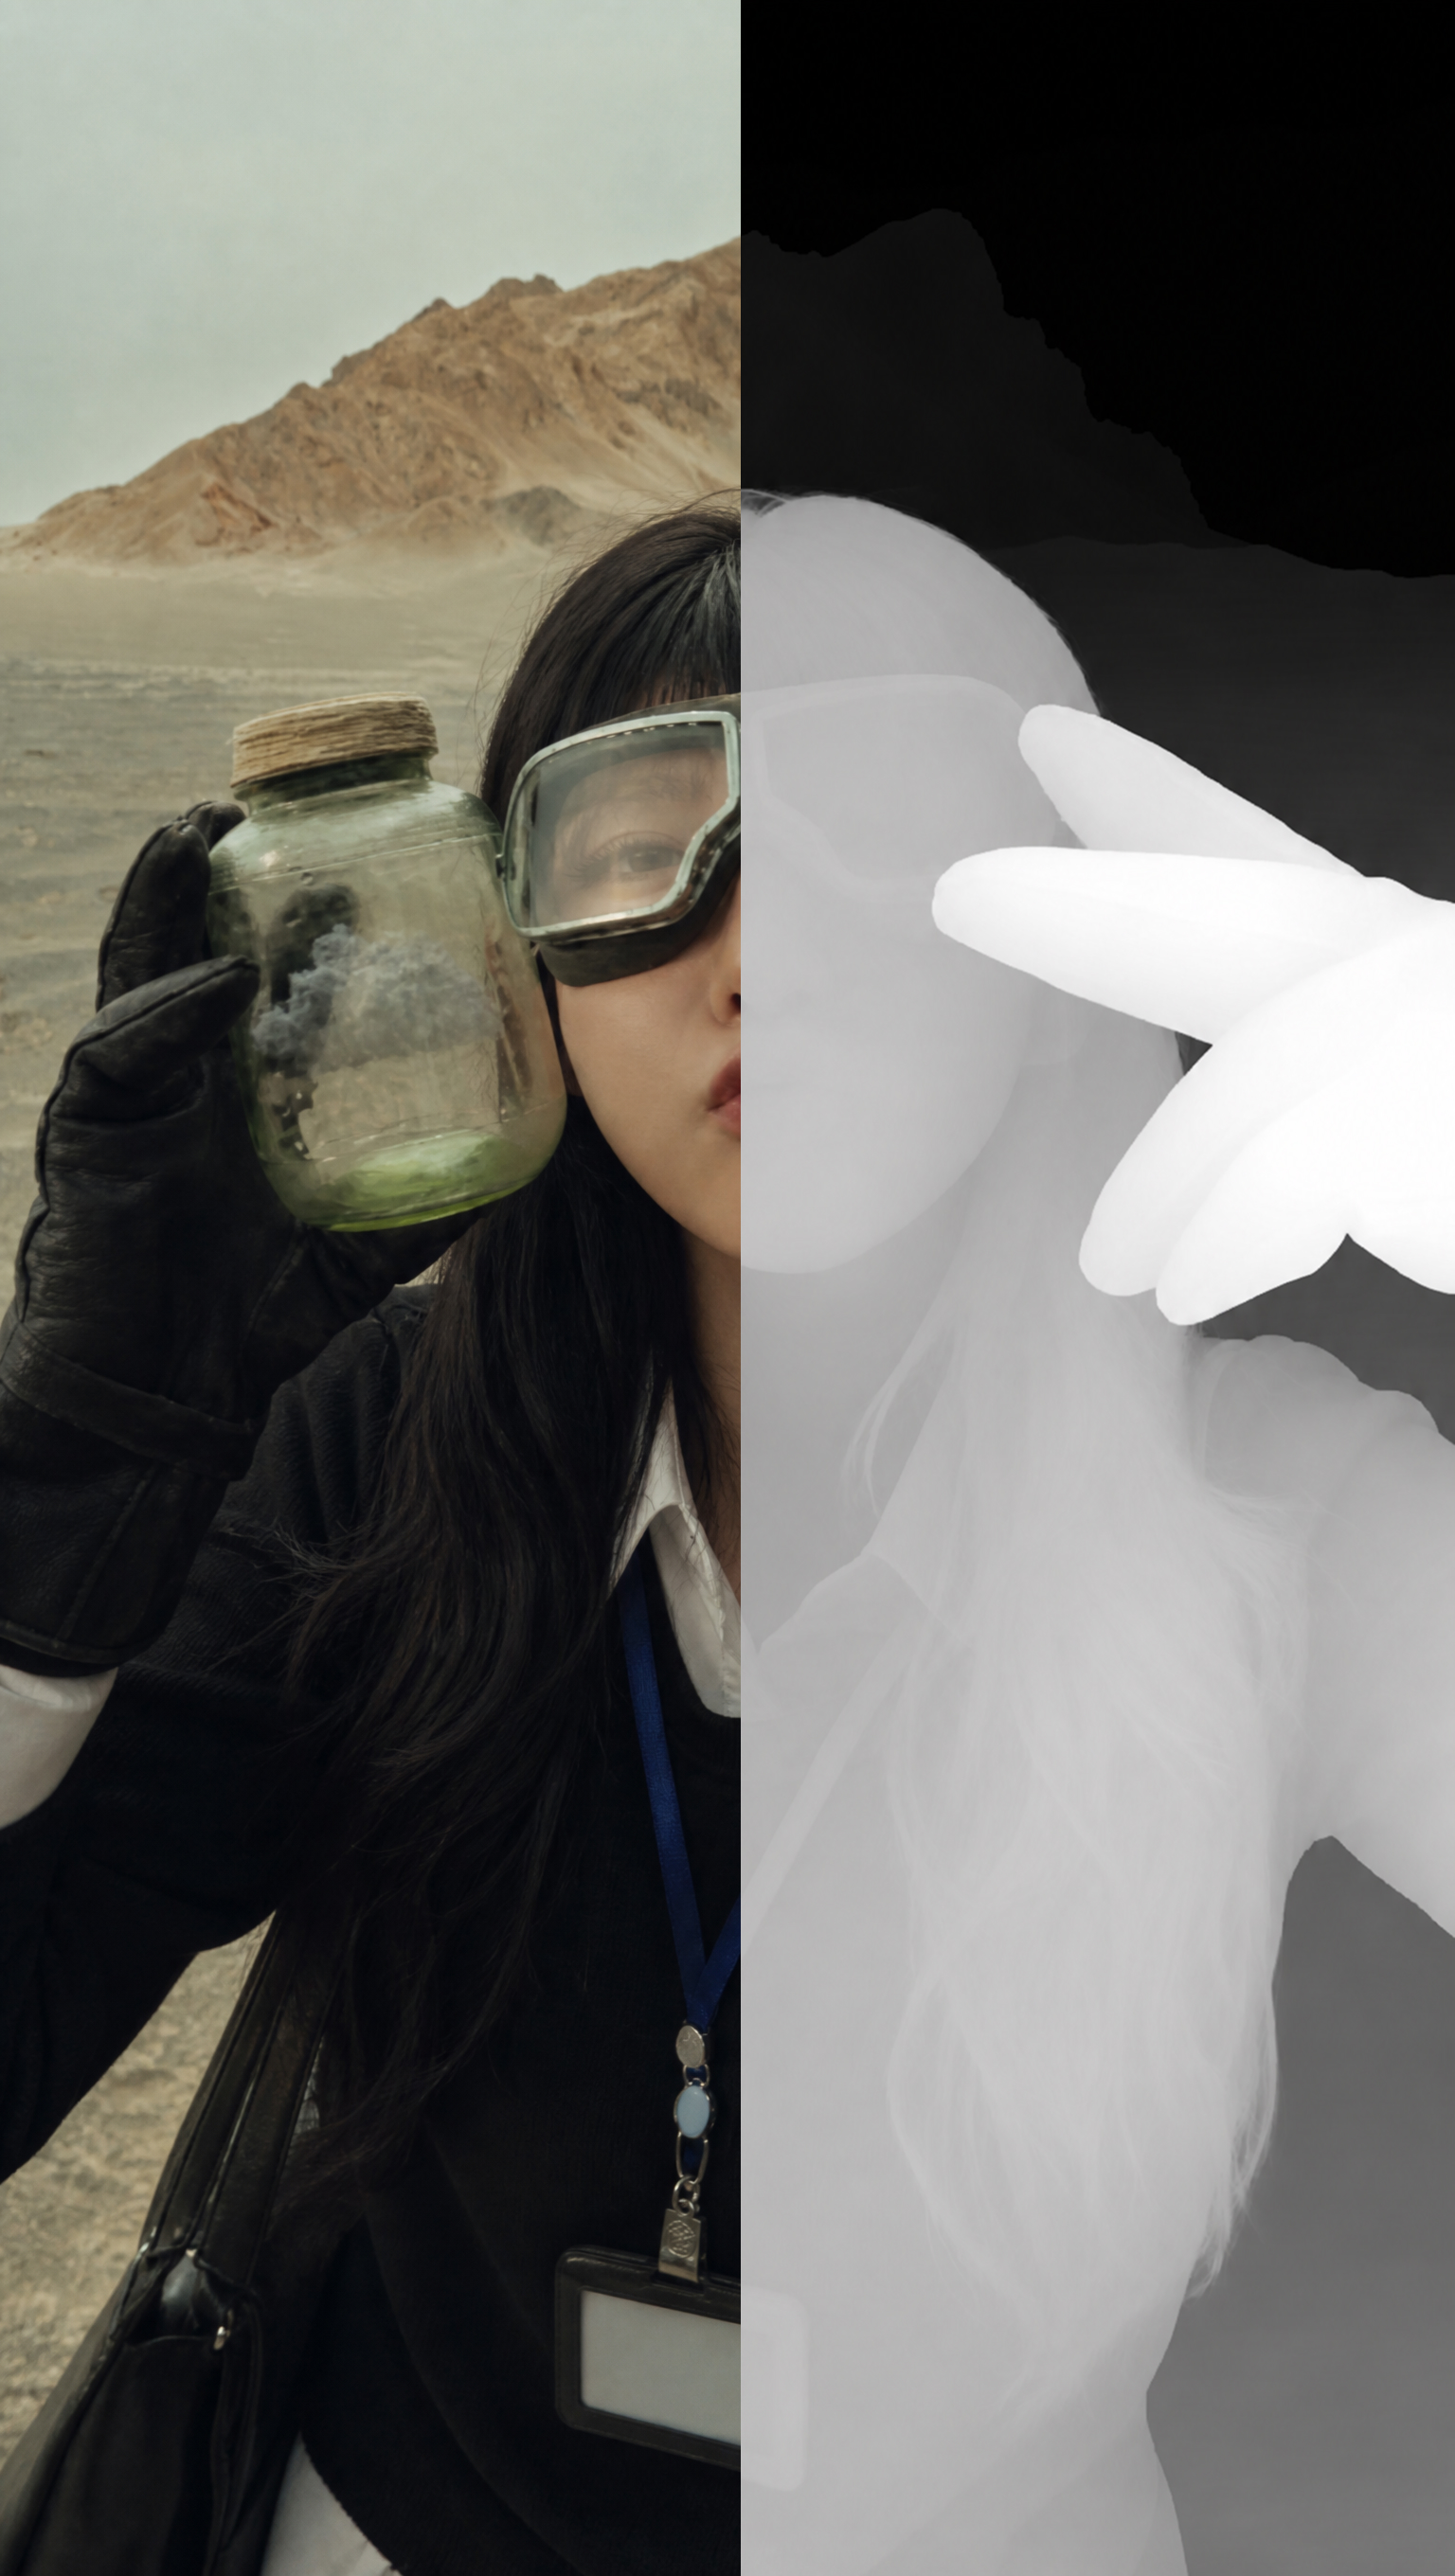
三、先决定你究竟想控制什么
并不是所有参考素材都要转成深度图。开始前,先问自己一句:我真正想从这份参考中保留什么?
如果想保留色彩、布光、材质或整体氛围,直接使用原图或风格参考更合适。如果想保留人物关节姿态,但允许场景和镜头变化,姿态骨架通常更直接。如果只想保留清晰轮廓,边缘图可能比深度图更灵活。如果需要保留构图、前后层次、主体尺度和遮挡关系,深度图才是合适的选择。
视频也一样。深度视频适合传递人物靠近或远离镜头、人物的大幅度动作、镜头推进或后退、主体与前景互相遮挡等空间变化。它不擅长描述手指如何捏住小物件、两个人的手如何交叉、绳索怎样缠绕。
四、图片工作流:从参考图得到可用的深度图
直接参考生成
在使用深度图之前,可以先做一次直接替换作为对照:同时上传人物姿态参考图、人物图和场景图,要求模型将参考姿态中的原人物替换为指定人物,再放入新的场景。
我用以下提示词去生成:
将图1中的原人物完整替换为图2中的人物,并把人物放入图3的场景中。
严格保留图1人物的身体姿态、头部朝向、四肢角度、手脚位置、身体重心、动作幅度、人物站位、主体大小、镜头视角和画面构图,不要重新设计动作。
新人物的脸部特征、发型、体型和服装以图2为准,彻底去除图1原人物的脸、发型、服装和身份特征,不保留替换痕迹。
场景内容、色彩、灯光和氛围以图3为准,但场景透视需要适配图1的镜头角度。人物脚部自然接触地面,身体比例正确,光线、阴影和环境色与场景自然融合。
人物表情为:【填写具体表情】。不要新增人物,不要改变动作,不要出现肢体错位、多余手指、人物悬空、边缘残留或背景变形。
最终生成一张人物身份准确、姿态一致、场景融合自然的完整彩色图片。
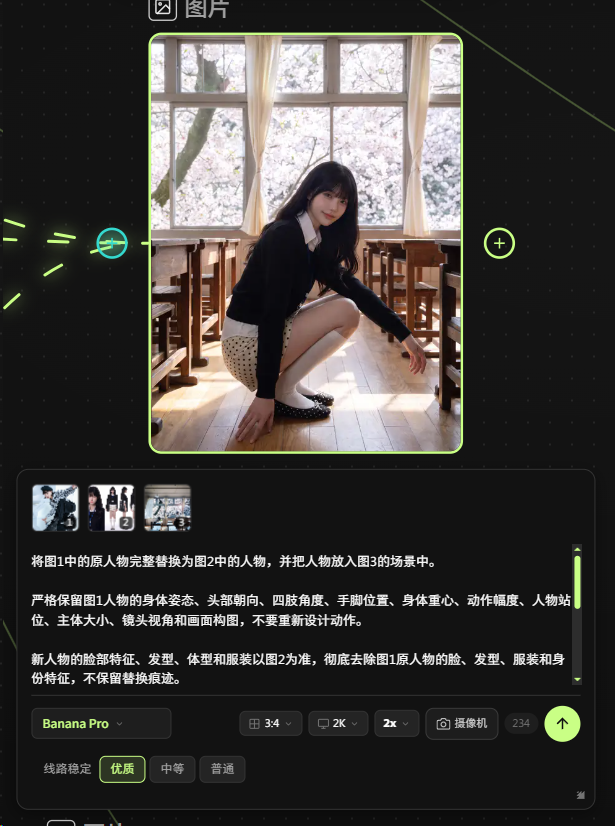
生成的效果极其不稳定,并且还会出现参考图中的乱七八糟的元素
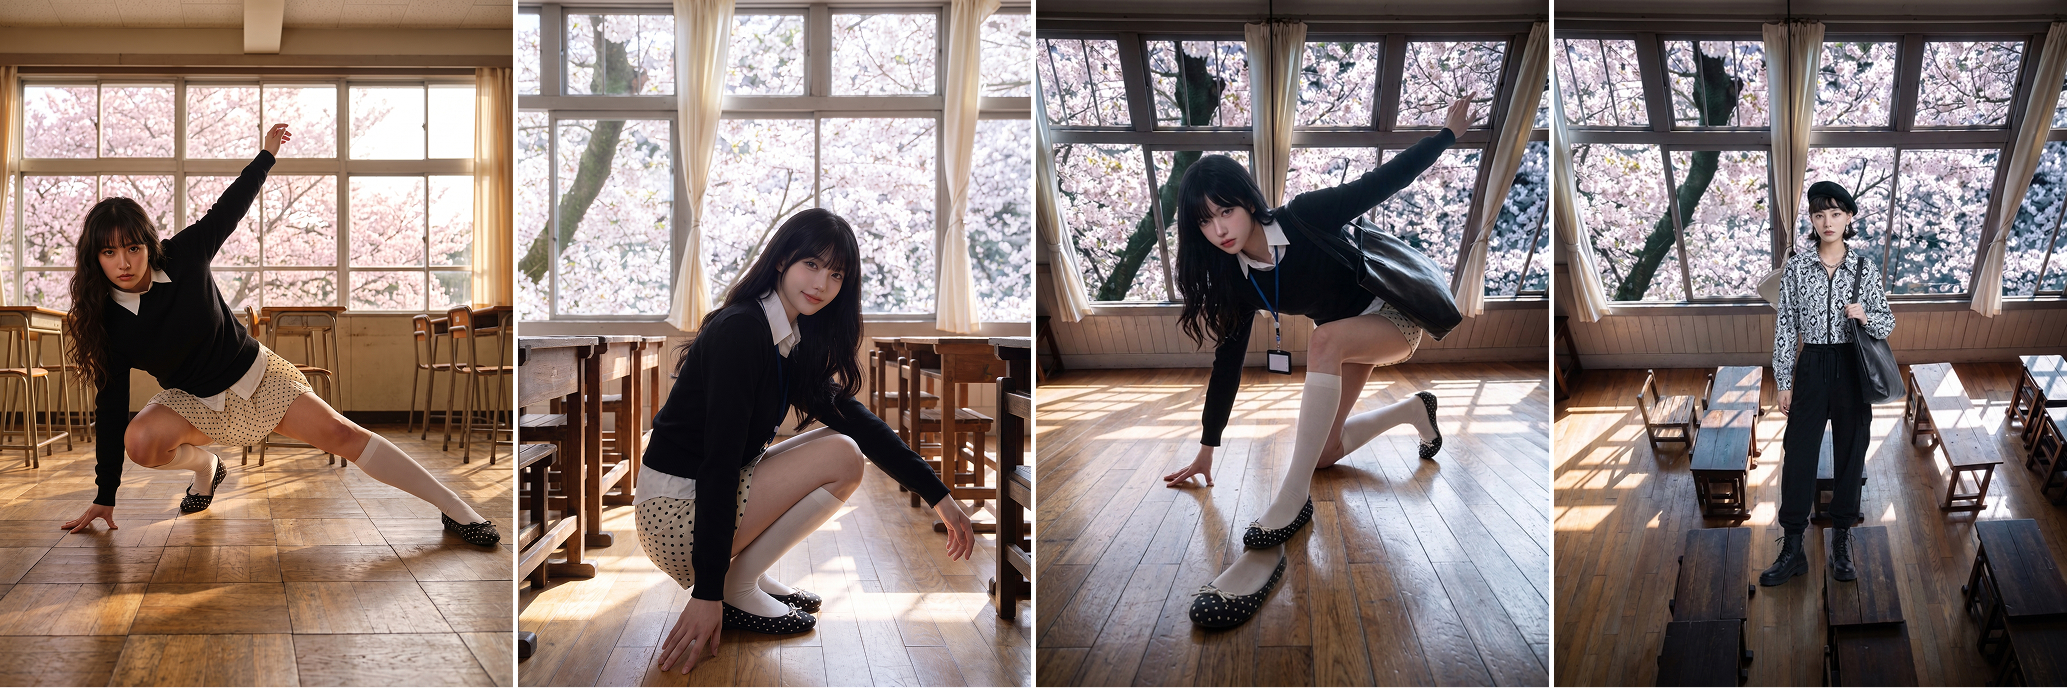
要不就是动作不到位,要不就是人物被替换,后者出现参考图中的东西
深度图参考生成
第一步
选择一张自己想要复刻的镜头与动作图。重点看它的机位、人物在画面中的位置、身体动作和前后空间关系,不需要先拆分成多种参考素材。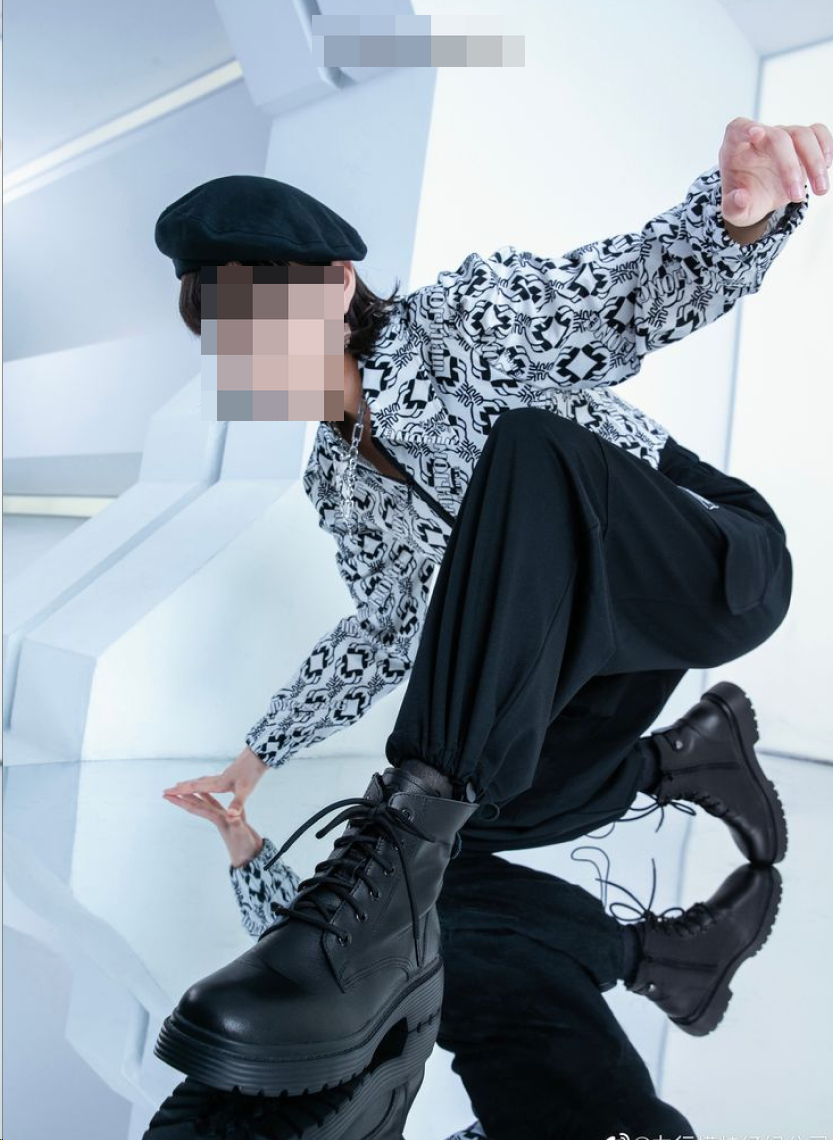
第二步
把参考图上传到 Image 2.0,让它转换为深度图。这里要告诉模型“转换原图”,而不是让它自由生成一张所谓的灰模,否则人物姿势和构图可能被重新设计。
可直接使用下面这段提示词:
把输入图片转换为单目相对深度图,用作后续图像生成的空间结构控制。必须保持:原图画幅比例、构图、镜头视角、主体位置与尺度、人物姿势、物体轮廓、前后遮挡关系和背景空间结构。深度规则:近处显示为白色,远处显示为黑色,中间距离使用连续灰阶;同一连续表面保持平滑的深度过渡,物体边界清晰。禁止:重新设计构图,移动、增加或删除人物与物体,改变姿势,补画新细节,保留原图颜色、纹理、文字、材质和光影风格。输出:只输出一张与原图尺寸一致的纯灰度深度图,不添加边框、说明文字、色彩图例或装饰。
第三步
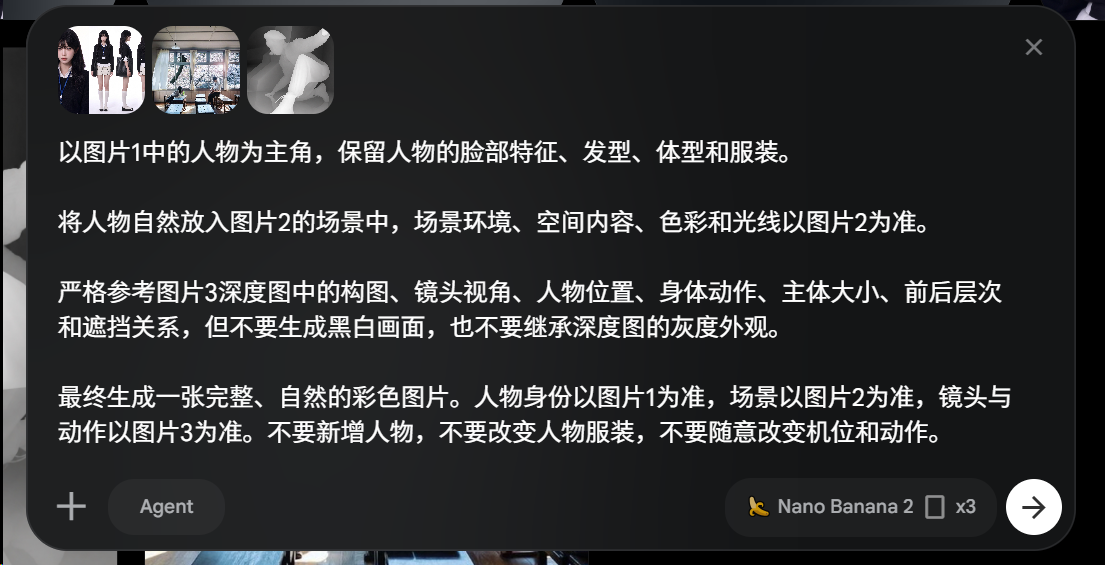
确认图片可用后,直接进入溶图环节。依次上传人物图、场景图和深度图,然后用一句提示词写清三张图的作用:人物图负责“是谁”,场景图负责“在哪里”,深度图负责“怎么站、从哪里拍、前后怎么排。
可以直接使用下面这段提示词:
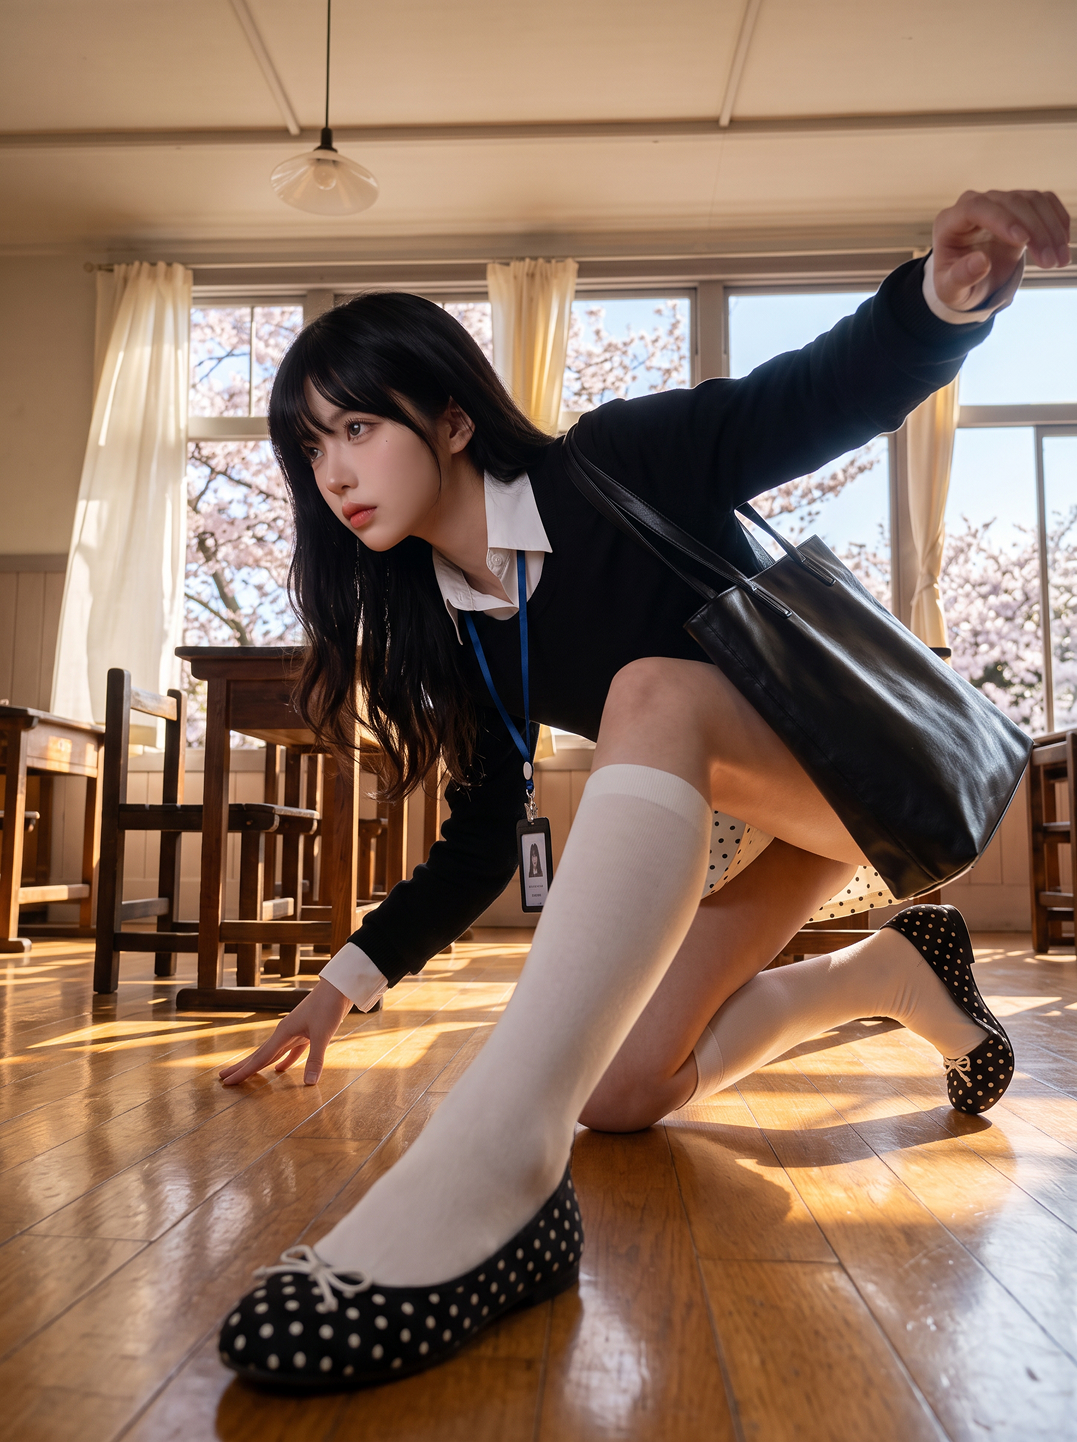
以图片1中的人物为主角,保留人物的脸部特征、发型、体型和服装。将人物自然放入图片2的场景中,场景环境、空间内容、色彩和光线以图片2为准。严格参考图片3深度图中的构图、镜头视角、人物位置、身体动作、主体大小、前后层次和遮挡关系,但不要生成黑白画面,也不要继承深度图的灰度外观。最终生成一张完整、自然的彩色图片。人物身份以图片1为准,场景以图片2为准,镜头与动作以图片3为准。不要新增人物,不要改变人物服装,不要随意改变机位和动作。
使用nanobanan 2生成
五、视频工作流
深度视频生成
深度视频不是简单地把视频逐帧变黑白,而是让每一帧都成为深度图,同时保持时间上的稳定。
建议使用codex就行转换。我这里找了一个舞蹈视频, 视频来源于@诗诗早上好
可以使用以下提示词:
请把我提供的视频转换为单目相对深度视频,原文件只读,不要覆盖。先确认唯一的输入视频;若找到多个候选文件,列出文件名并询问我,不要自行猜测。使用可用的单目视频深度估计模型处理全部帧,采用统一的模型、预处理方式和深度方向。近处为白,远处为黑。保持原视频的画幅比例、帧率、总时长、帧顺序和镜头运动。对整段视频使用统一的深度归一化范围,不要逐帧自动拉伸对比度;进行适度时间稳定,减少闪烁。输出H.264编码的MP4 720p 深度视频,并且以15s一段就行拆分,不保留原音频,不覆盖原文件。
转化后的视频如下:
得到深度视频后,再把它与角色设定图、服装图或风格图一起交给seedance2.0生成。提示词可写成:
根据我提供的三类参考素材生成一段完整的彩色视频。
人物参考图:用于确定主角身份。严格保留人物的脸部特征、发型、体型、服装和整体外观,不要替换成深度参考视频中的人物形象。
场景参考图:用于确定故事发生的环境。保留场景中的空间布局、主要物体、色彩、光线和整体氛围,并让人物自然融入场景。
深度参考视频:作为动作与运镜的主要模板。严格模仿其中人物动作的起始姿势、动作顺序、移动方向、速度、幅度、重心变化、停顿时间和结束姿势;同时严格模仿镜头的机位高度、拍摄角度、景别变化、移动方向、运动速度、推进、后退、摇移、跟随和环绕轨迹。
保持参考视频的动作节奏、镜头节奏、人物走位、主体大小、前后层次、遮挡变化和画面重心。不要随意增加动作、改变运动方向、交换左右位置或重新设计运镜。
只继承深度参考视频中的动作、走位、空间关系和镜头运动,不继承它的黑白灰度外观、人物身份、服装或原场景。最终人物以人物参考图为准,最终环境以场景参考图为准,动作与运镜以深度参考视频为准。
保持人物身体结构自然,动作前后连贯,脚步与地面接触稳定,手部和道具关系合理。不要新增人物,不要改变主要道具数量,不要出现肢体错位、人物漂移、背景跳动或镜头突然反向。
输出一段画面稳定、动作连贯、运镜与深度参考视频尽可能一致的完整彩色视频。
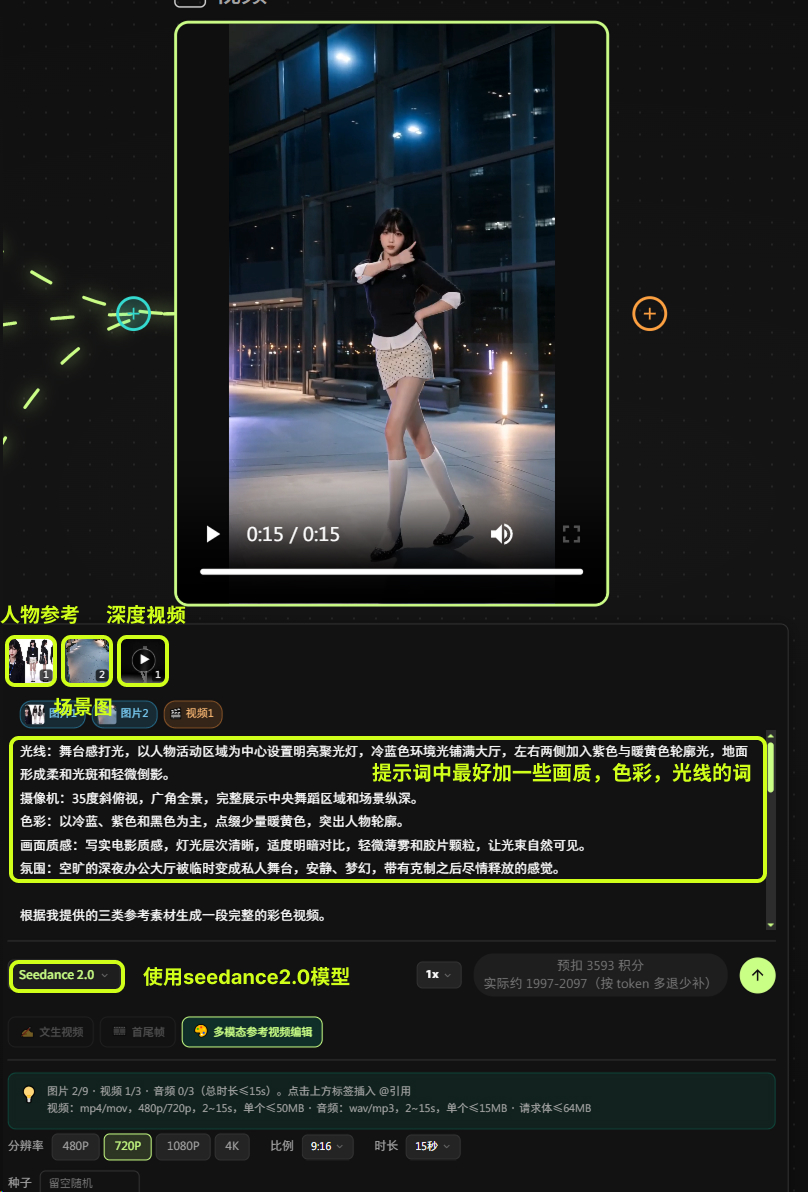
我生成了俩段15s视频然后拼接起来
六、深度图不能控制什么
深度图主要记录物体与镜头之间的远近,只能帮助模型理解大致构图、人物位置、身体轮廓和前后关系。它不是人物细节图,因此不能指望它准确保留所有动作和表情。
首先,深度图很难记录表情和眼神。微笑、皱眉、眨眼、嘴巴开合以及视线方向,通常不会形成足够明显的距离变化。人物的脸在深度图里可能只是一块灰色区域,因此深度图只能确定脸部的大致位置和朝向,具体表情还需要通过提示词进一步完善。
例如可以补充:“人物轻微皱眉,嘴唇抿紧,目光看向画面左侧,神情紧张但克制。”描述时要写清眉毛、眼睛、嘴部和情绪状态,不要只写“表情自然”。
其次,手指和细小动作很容易出错。手指之间距离接近,又经常互相遮挡,转换后可能粘成一团,甚至缺少手指。抓握、递东西、按按钮、握住车把等动作,不只需要知道前后位置,还需要理解手指如何弯曲、手掌接触哪里,这些信息无法只靠深度图完整表达。
视频生成执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课不是先追求炫技成片,而是围绕「刺猬星球super-i_AI教程免费在线教学」先把主体、动作、镜头和节奏稳住。
按原文节奏走最稳:先吃透「深度图到底是什么」,再把「灰度图、灰模和深度图不是一回事」定住,接着处理「先决定你究竟想控制什么」;最后用「图片工作流:从参考图得到可用的深度图」收口。
- 先把「深度图到底是什么」里的主体和动作定死。
- 这一段重点看镜头和节奏,别急着炫技。
- 做完「先决定你究竟想控制什么」后,先查连贯性和穿帮。
- 围绕「图片工作流:从参考图得到可用的深度图」只取局部结构,别整张照搬。
- 做完「深度图不能控制什么」后,先查连贯性和穿帮。
不要一上来就生成最终片;先拆镜头、定主体和运动,再逐段生成,否则容易跳轴、穿帮、节奏混乱。
检查主体是否稳定;镜头运动是否明确;前后画面是否连贯;节奏是否服务主题;是否有明显变形或穿帮。
请围绕「刺猬星球super-i_AI教程免费在线教学」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:核心创意、分镜表、每个镜头的画面描述、视频生成提示词、剪辑顺序和成片自检清单。要求主体稳定、动作明确、镜头连贯。