一起来看一下成品:
准备工具
Gemini https://gemini.google.com/app
image2.0
https://www.flowpix.club/bj/26677.html?token=828cc3a2f55bad71106f7f253edf85d7
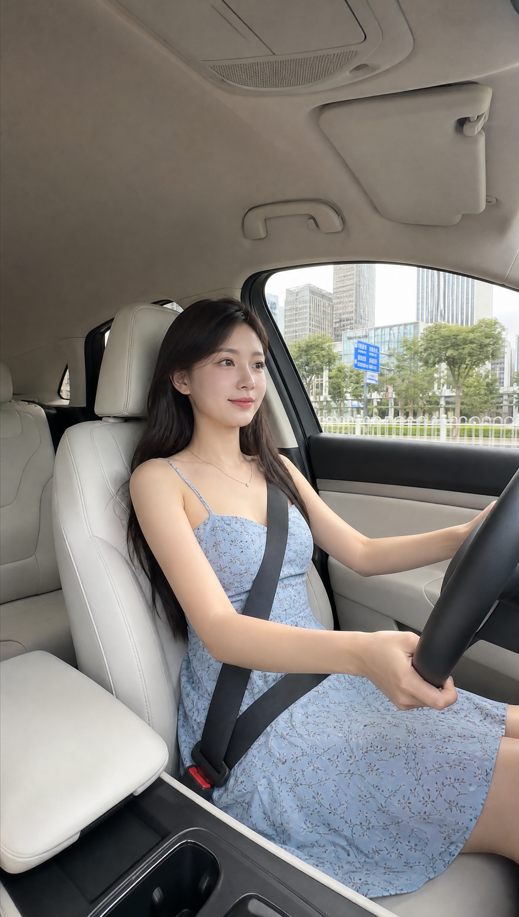
第一步,先生成一个人物开车的基础视角。
这里不要一开始就追求很多动作,先把画面结构做对。
这一步的重点不是穿搭,而是把“车内开车视角”固定下来。
这里是提示词模板(使用image2.0生成。豆包也行不过效果一般):
车内副驾驶位正面微侧视角,镜头位于副驾驶前方偏中控位置,面对驾驶员拍摄,画面构图方向明确:驾驶员坐在画面左侧偏中间,身体基本正对镜头,脸部和视线轻微转向画面右侧前方道路,人物不是朝画面左侧看。方向盘位于画面右侧前景边缘,只露出约三分之一,尺寸适中,不要过大,不占据画面中心,不遮挡人物身体和脸部。车窗和城市街景主要出现在画面右侧背景,白色驾驶座椅在人物身后偏画面左侧,人物身后和座椅侧后方能隐约看到一点后排白色座位,后排座椅只作为背景轻微露出,不是画面主体。视角接近平视或略低,镜头进一步后退,使用竖屏车内环境中远景构图,带有副驾驶位手机随拍感。人物不是近景写真,不是半身特写,不是大头照,不是脸部特写,不是胸口以上裁切。人物占画面高度约 40% 到 50%,不要超过画面高度的一半,人物在画面中显得更小一些。使用手机 1x 标准镜头视感拍摄,正常透视关系,不使用广角,不使用 0.5x 或 0.7x,不要夸张空间拉伸,不要边缘畸变,不要拉长脸、身体、手臂和车内结构。镜头通过适当后退来保留车内环境信息,而不是依靠广角扩大画面。整体呈现自然手机随拍感,画面比例真实,人物与车内空间关系准确。画面保留大量车内空间和环境信息,头顶上方、身体两侧、腿部下方都有明显留白。画面下沿拍到大腿上方、座椅坐垫和部分中控区域,能清楚看到驾驶员从头部、肩颈、上半身、腰部到连衣裙裙摆上半部分。浅蓝色细吊带小碎花连衣裙需要露出吊带、胸口、腰和裙摆上半部分,安全带斜跨在连衣裙上,但人物整体不要占满画面。-不要噪点、颗粒感、伪影、高频细节(指过于细碎复杂的纹理)、脏污质感、过度锐化、斑驳感以及混乱的细节。
第二步,使用自己的人物模特进行换脸。
基础图出来之后,我会把人物换成统一的模特脸。
这里建议大家使用自己有授权的人物模特,或者使用自己生成的虚拟人物。不要随便拿真人照片去换脸,尤其是没有授权的人像素材。
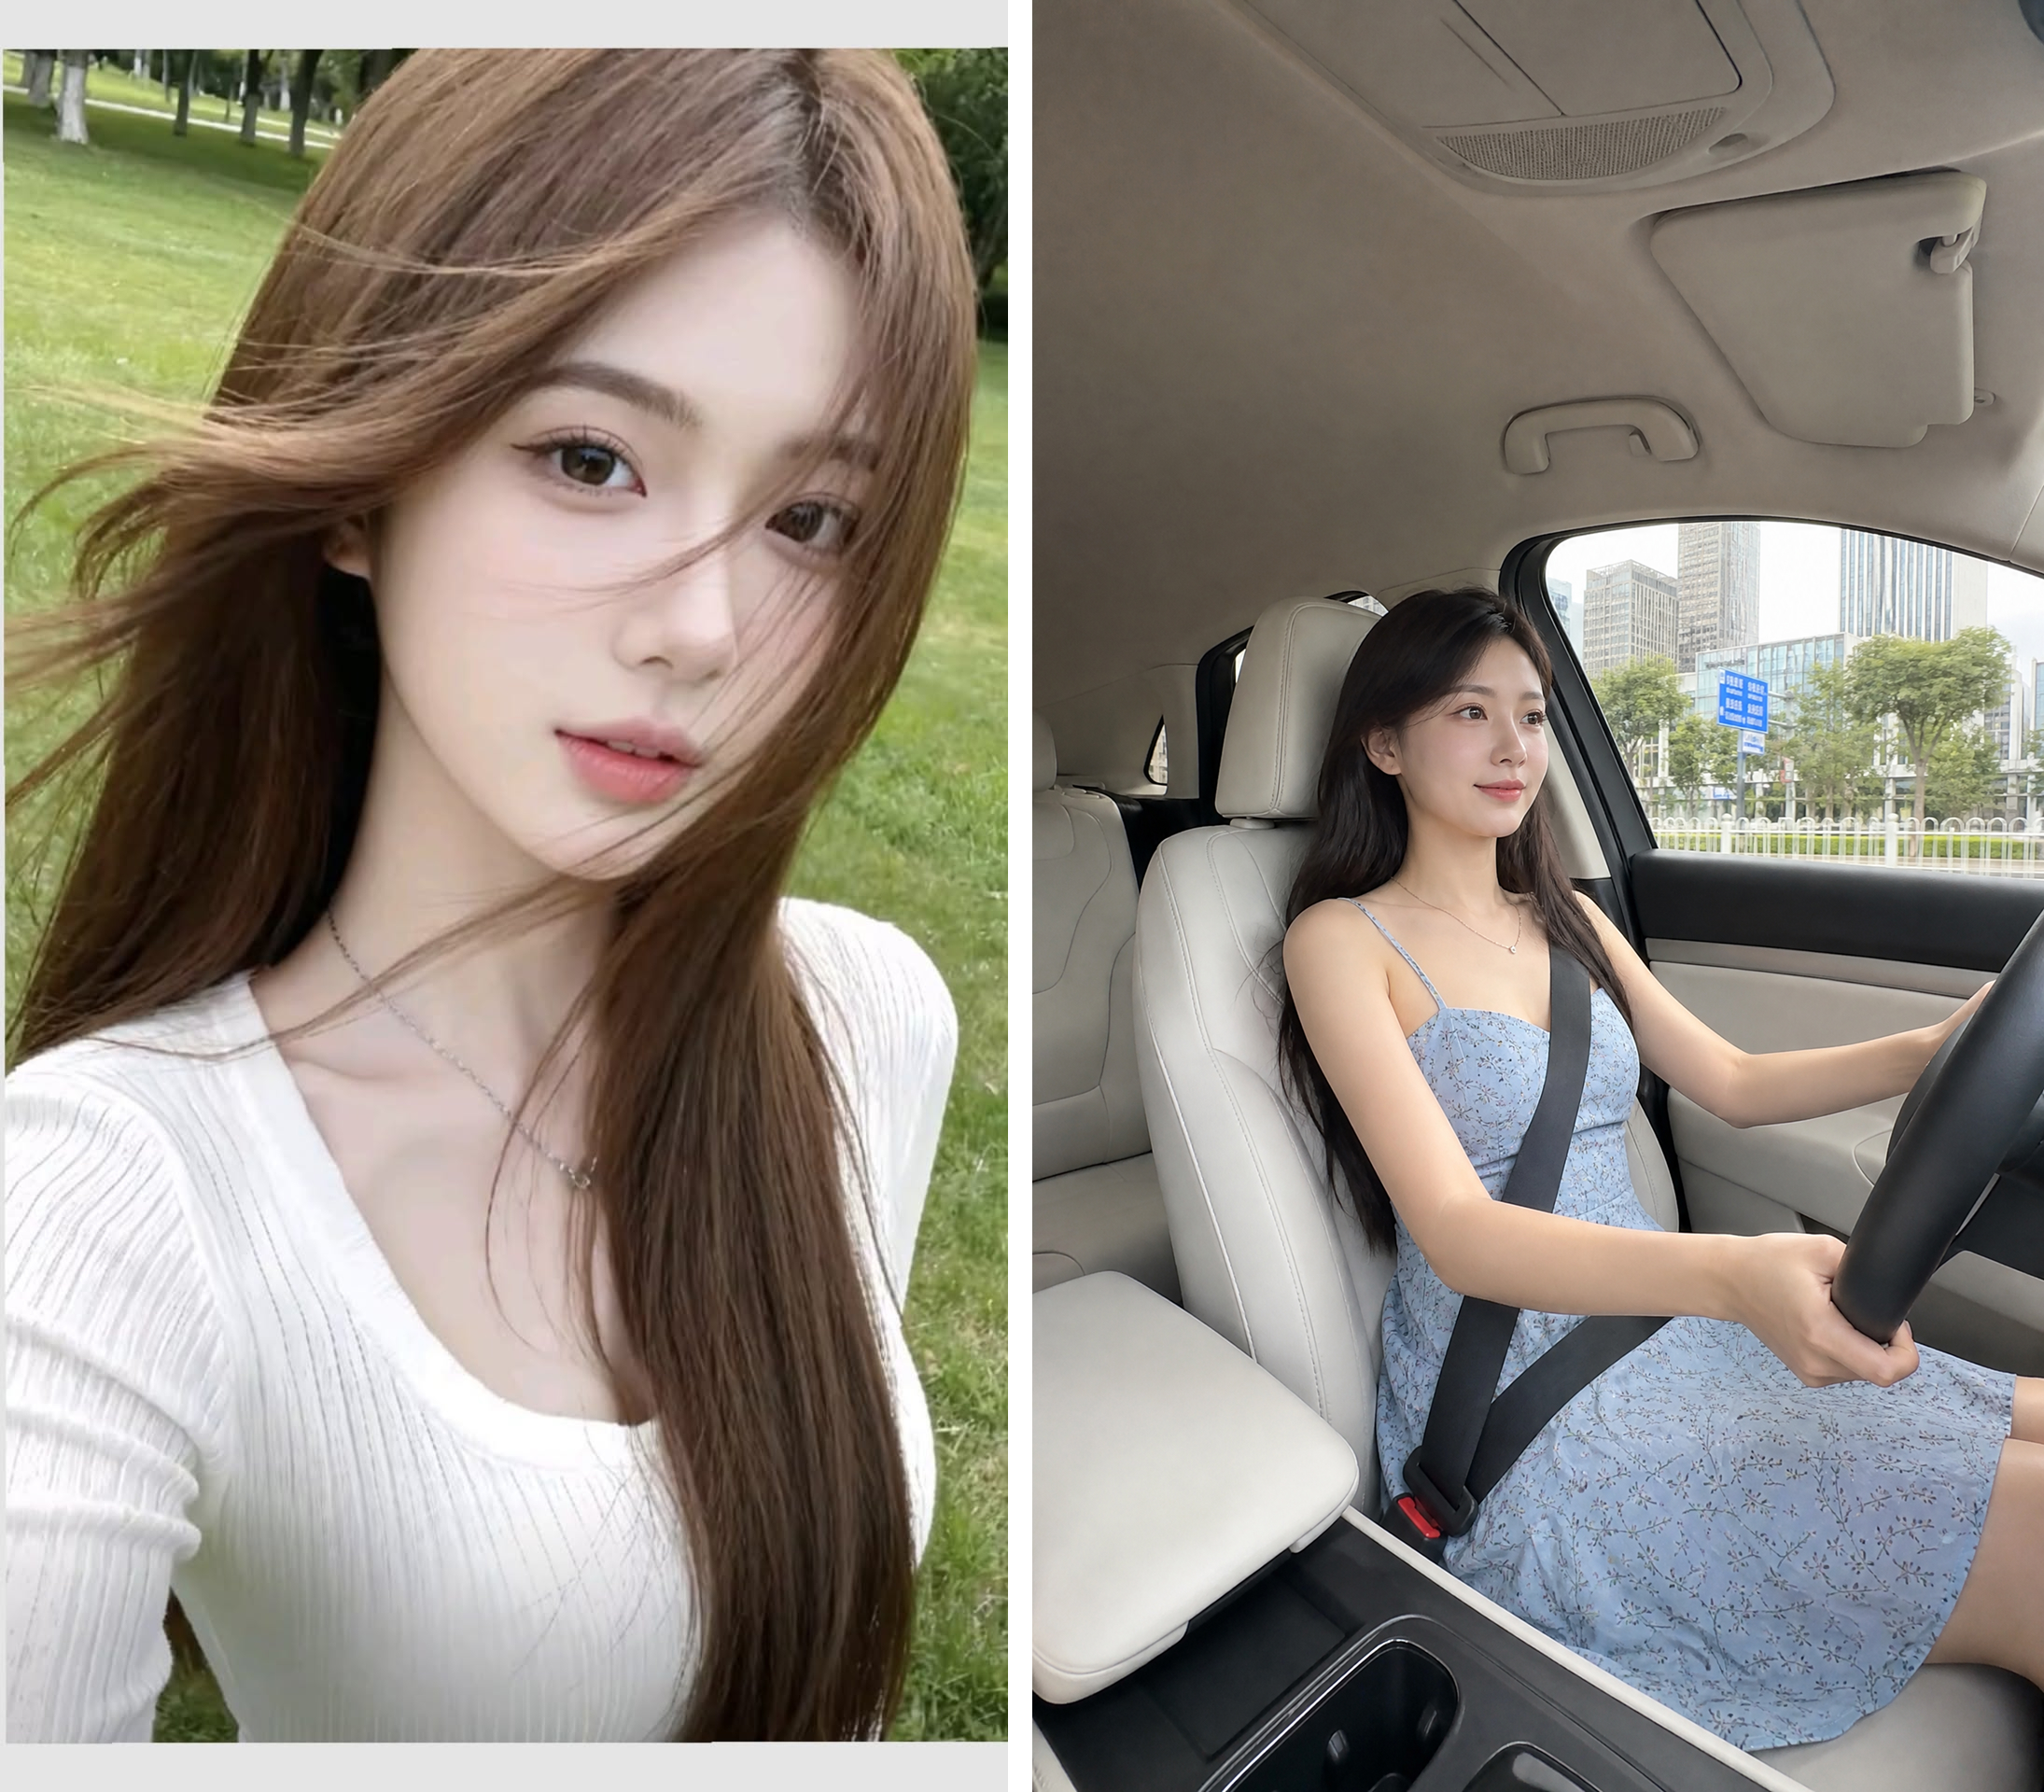
使用nanobanan pro生成,以下是提示词:
将图2的人物面部特征替换至图1人物上
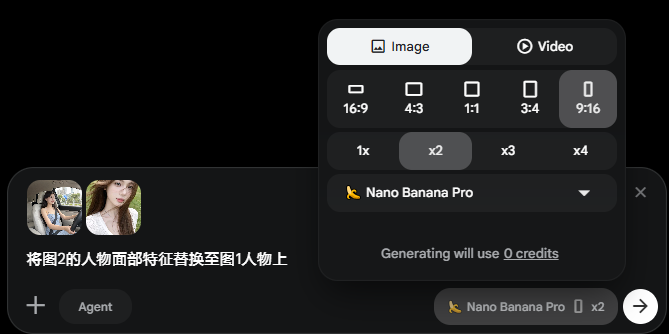
谷歌 flow界面
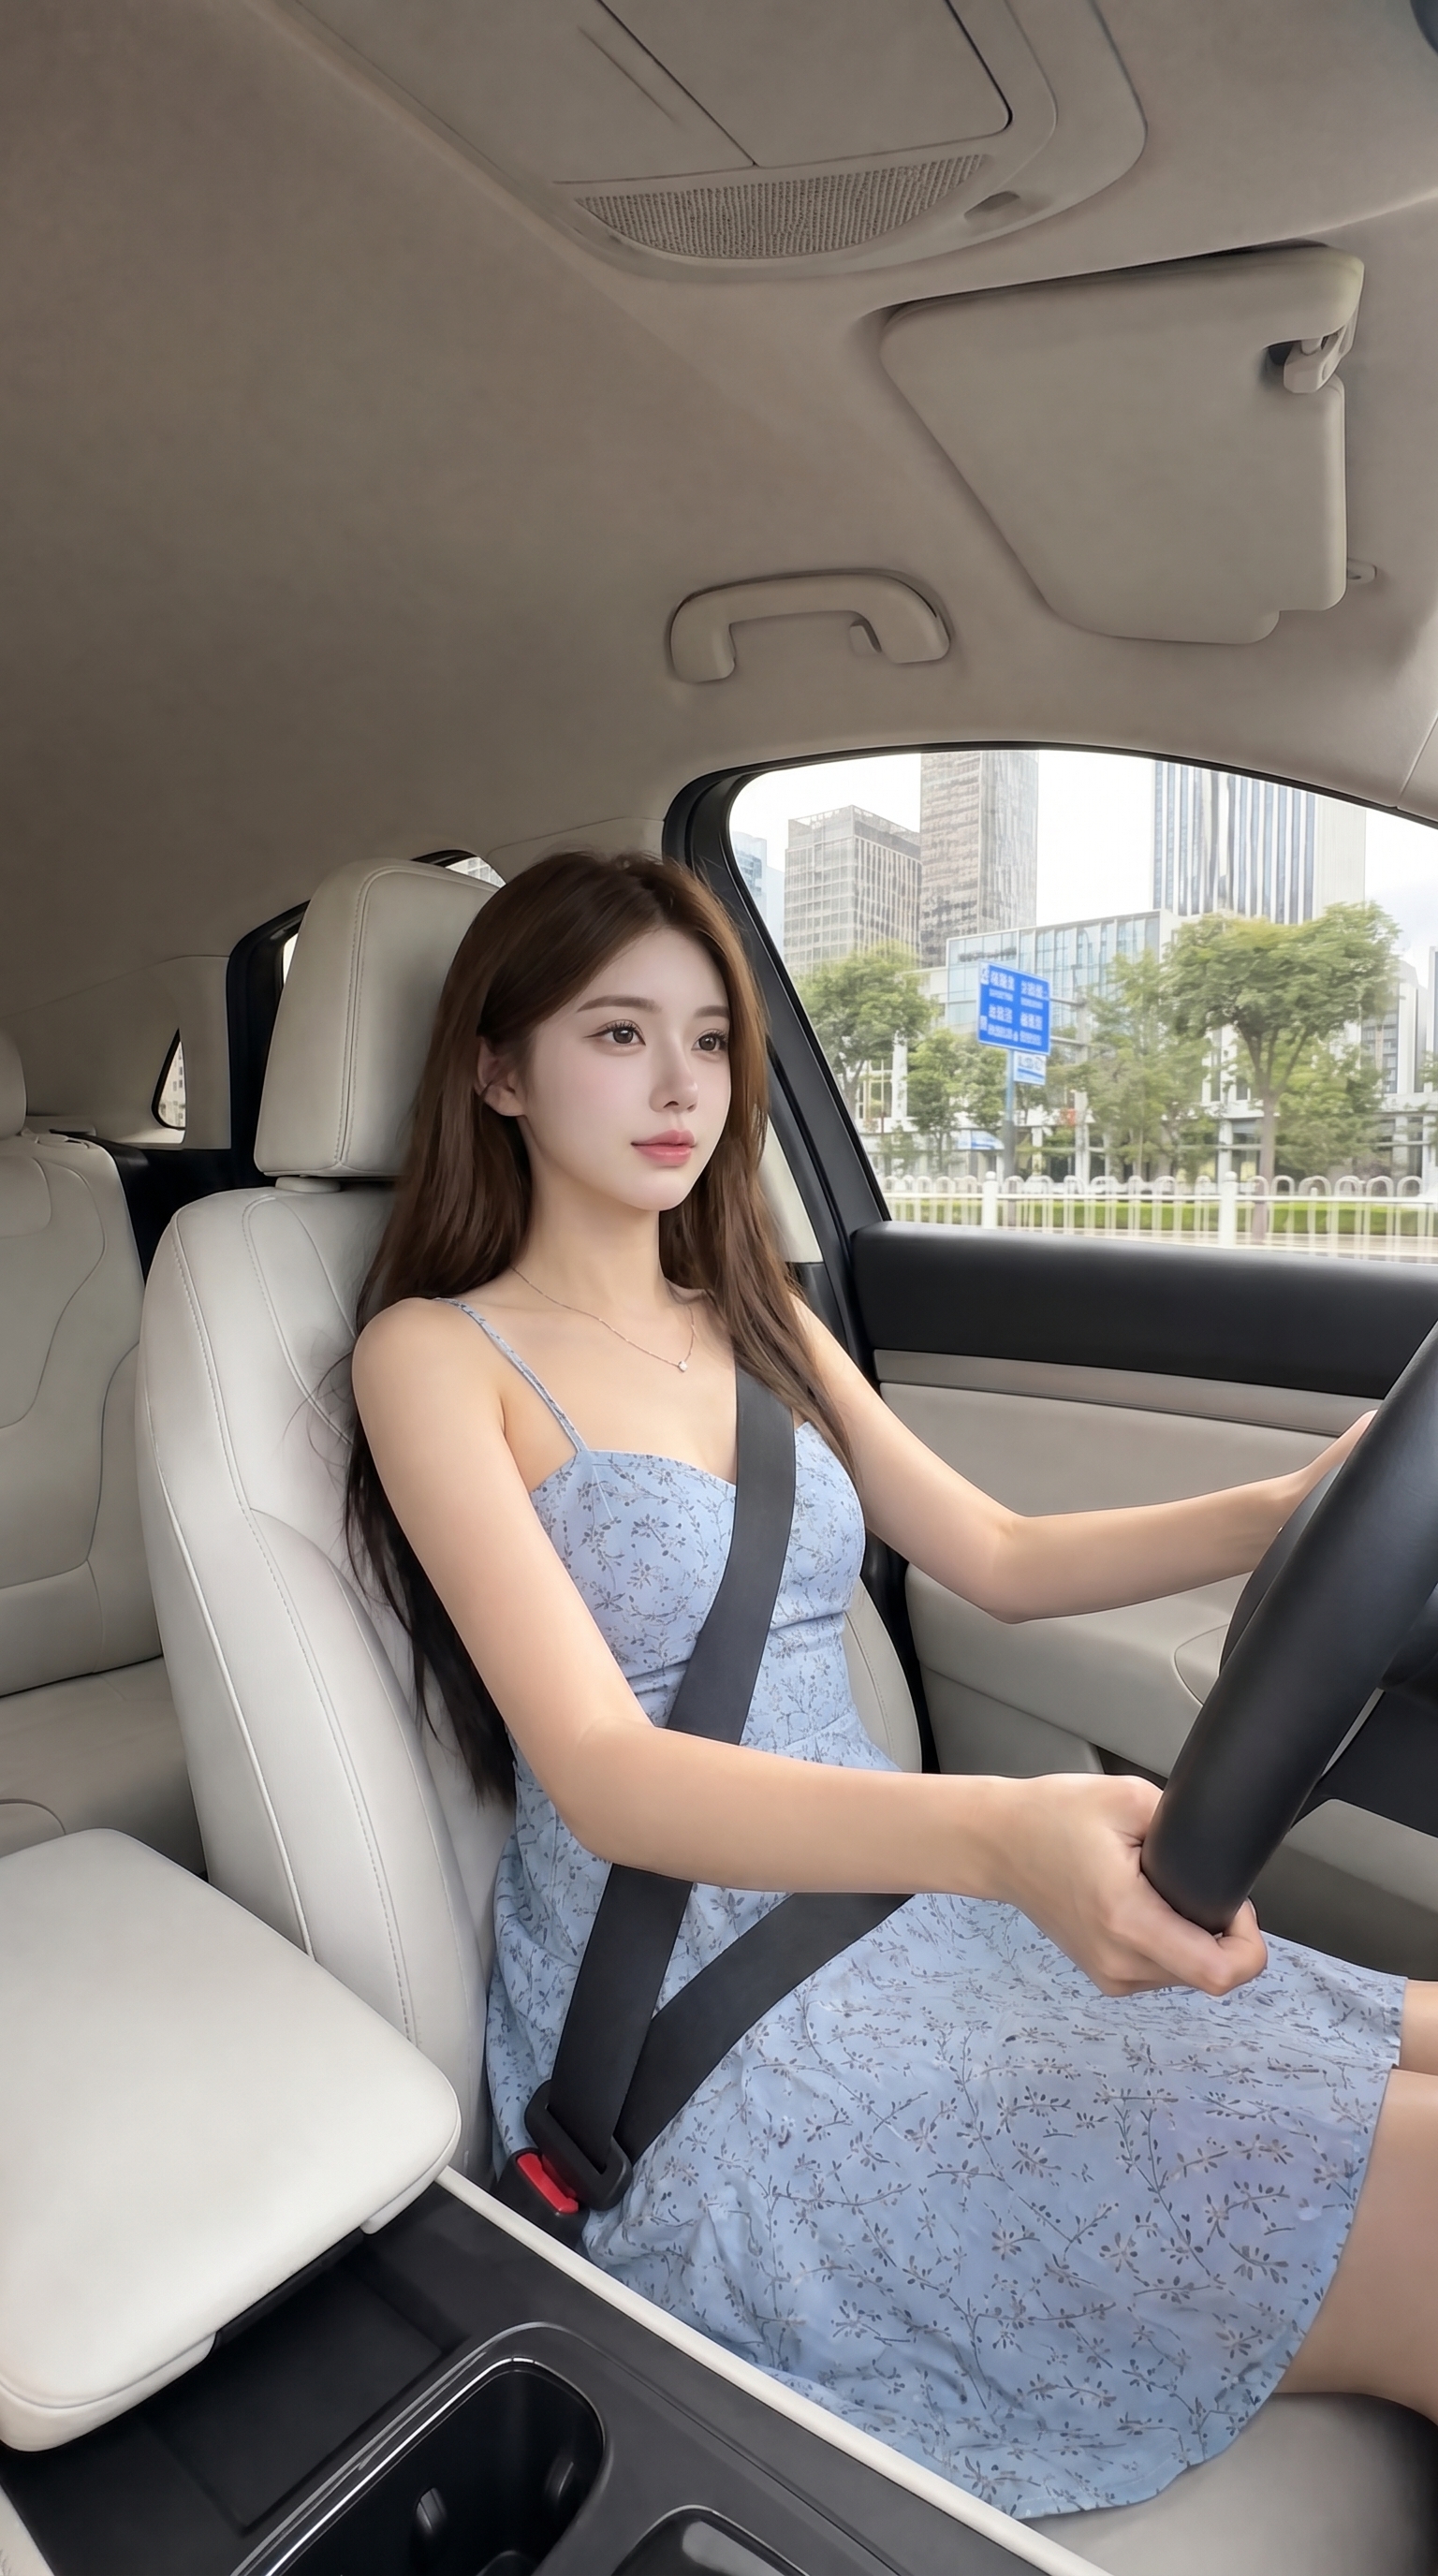
生成的图片
第三步,搜集一周穿搭的 7 张图片。
这一步需要准备周一到周日的七套穿搭图。最好是白底图,因为白底图的服装结构最清楚,AI更容易识别衣服款式、颜色、材质和轮廓。
如果没有白底图,也可以用全身穿搭图,但尽量选择人物站姿清楚、衣服没有被遮挡、光线干净的图片。
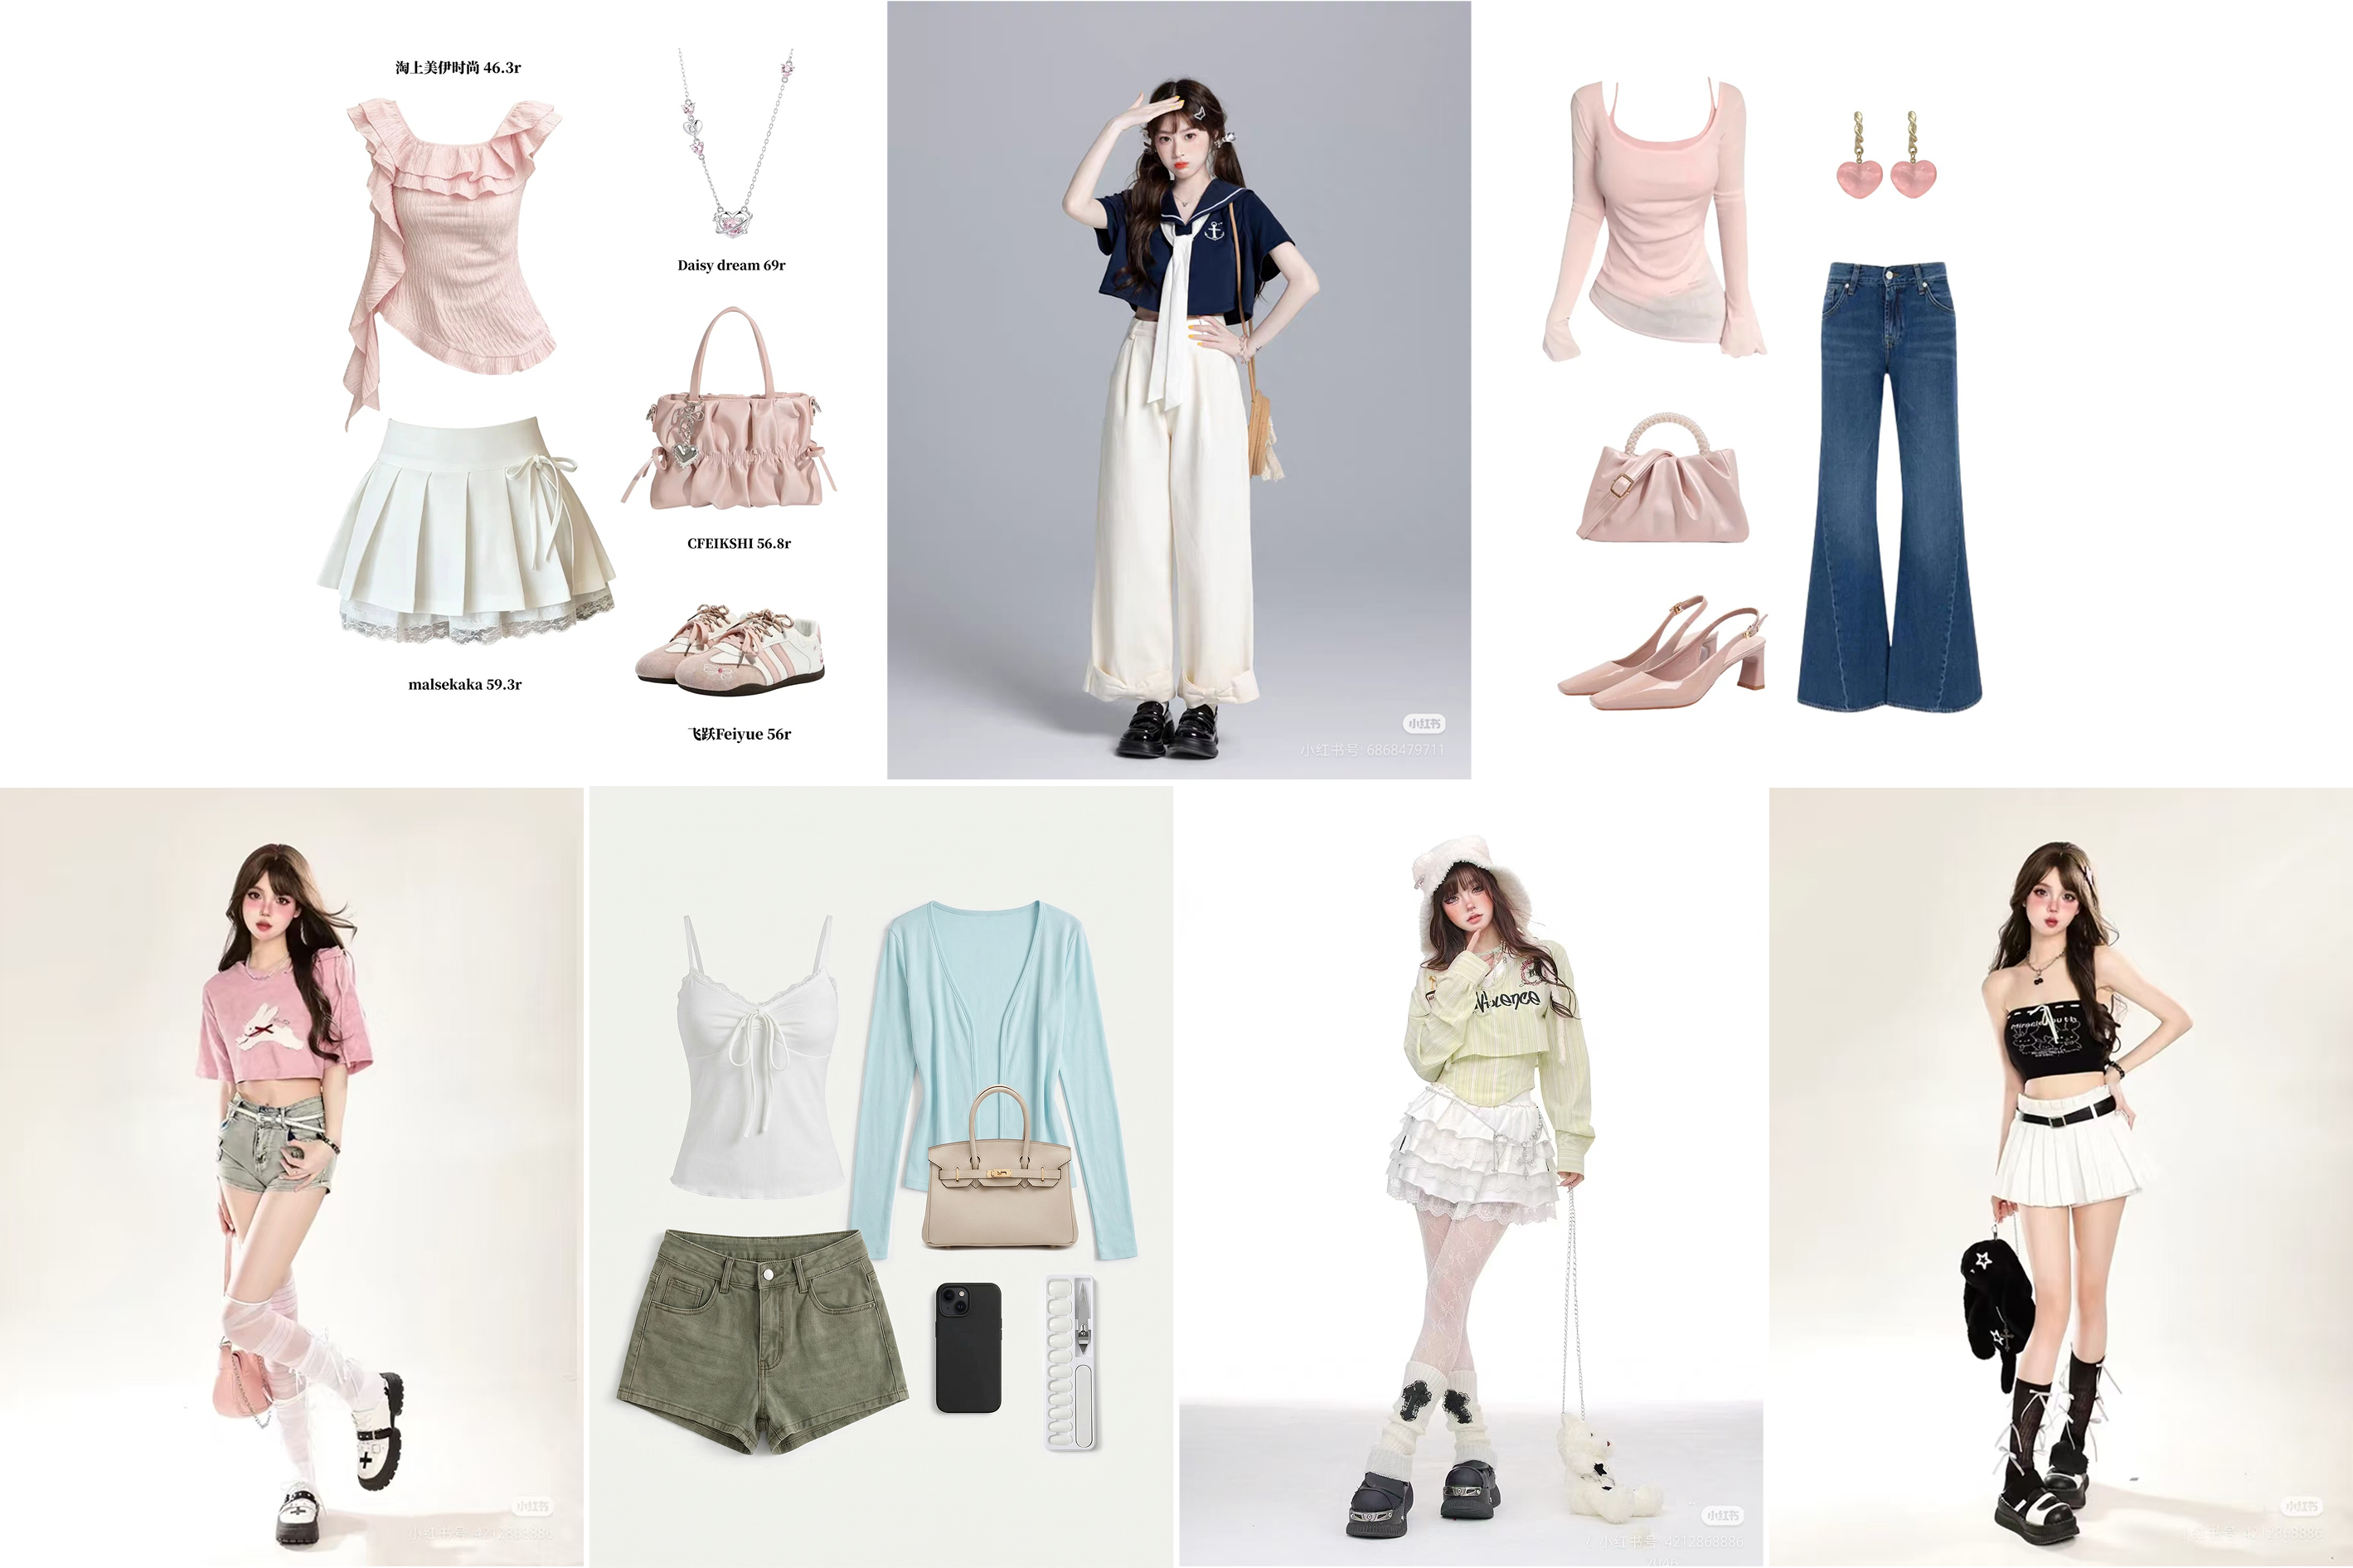
这是我找到的7张穿搭图
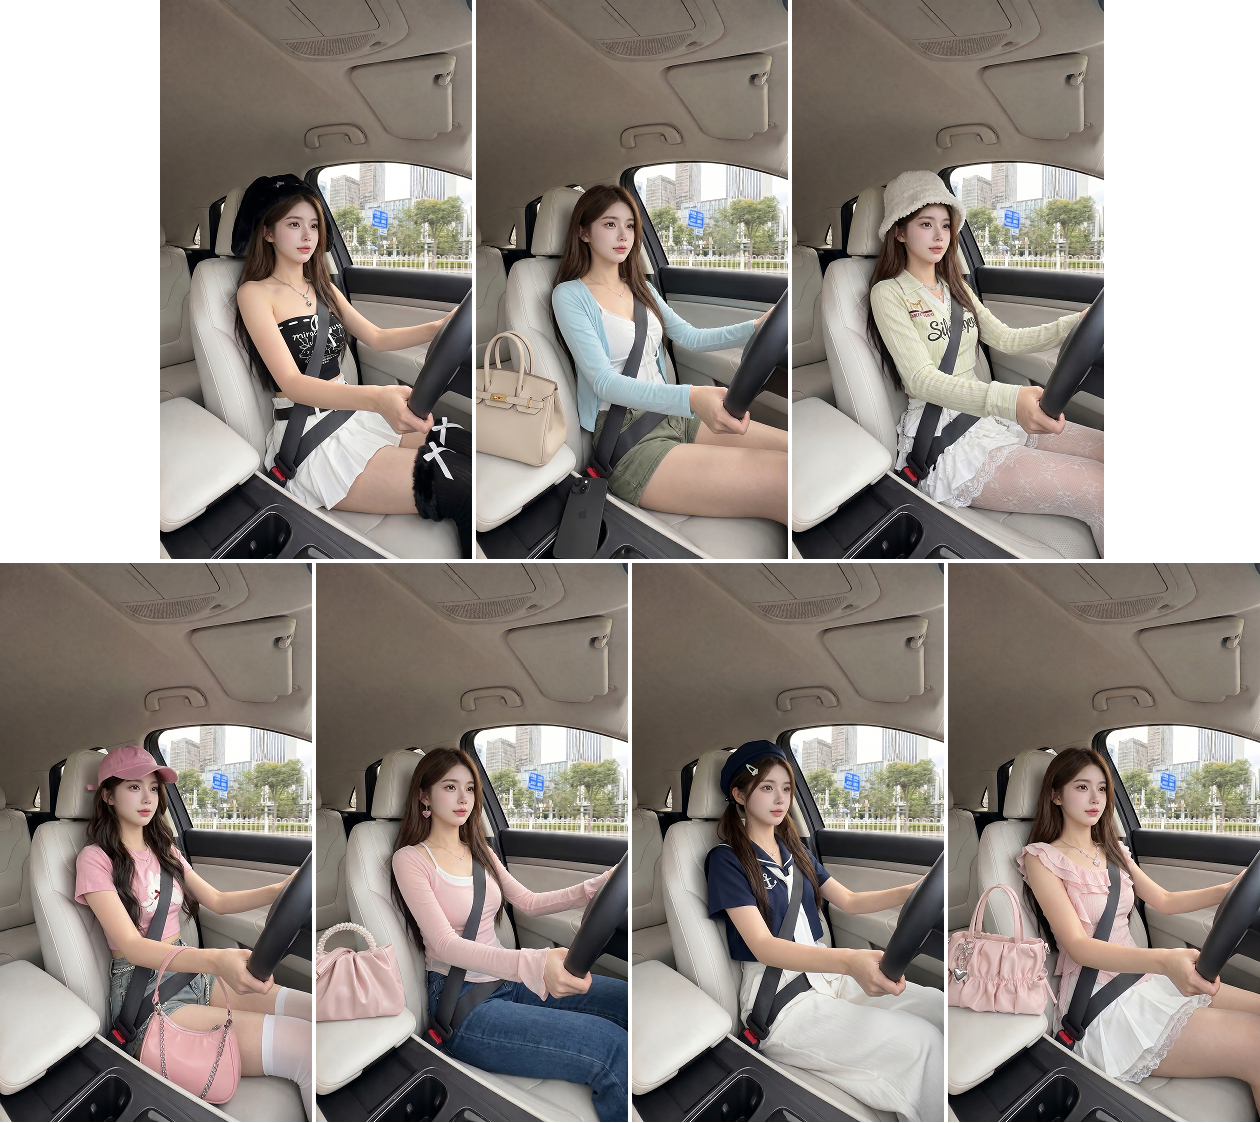
然后把这七套衣服分别替换到前面统一的人物开车图上。
输入以下提示词,将服装图和开车图一起上传生成(使用nanobanan pro):
让第一张图中的人物穿上第二张图中的整套服装,以及发型,帽子。同时完整保留图 1 的所有原有元素:画面构图,人物姿态,肢体神态,拍摄角度,发型走向。服装的每一处细节 —— 颜色、材质、领口、袖型、长度、花纹 —— 都必须和第二张图一模一样。高细节,真实感
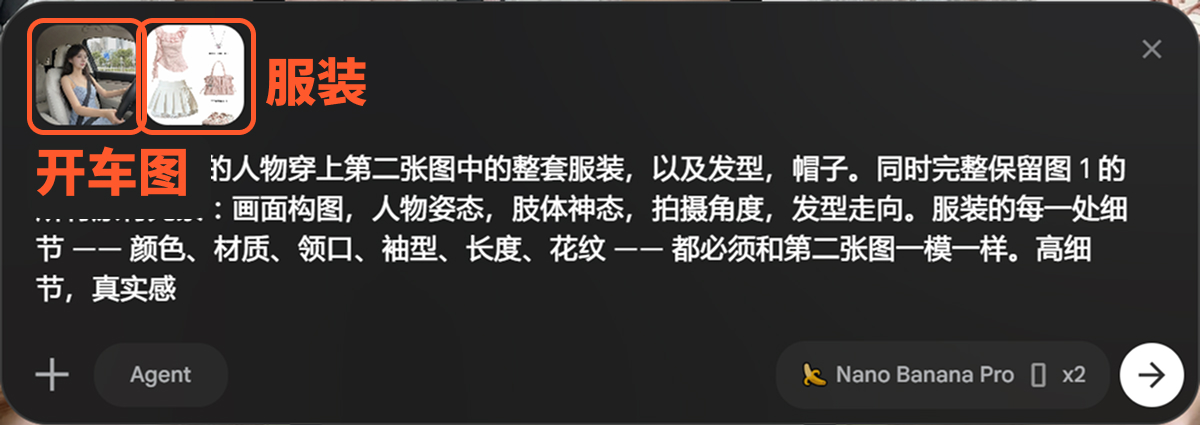
谷歌flow操作界面
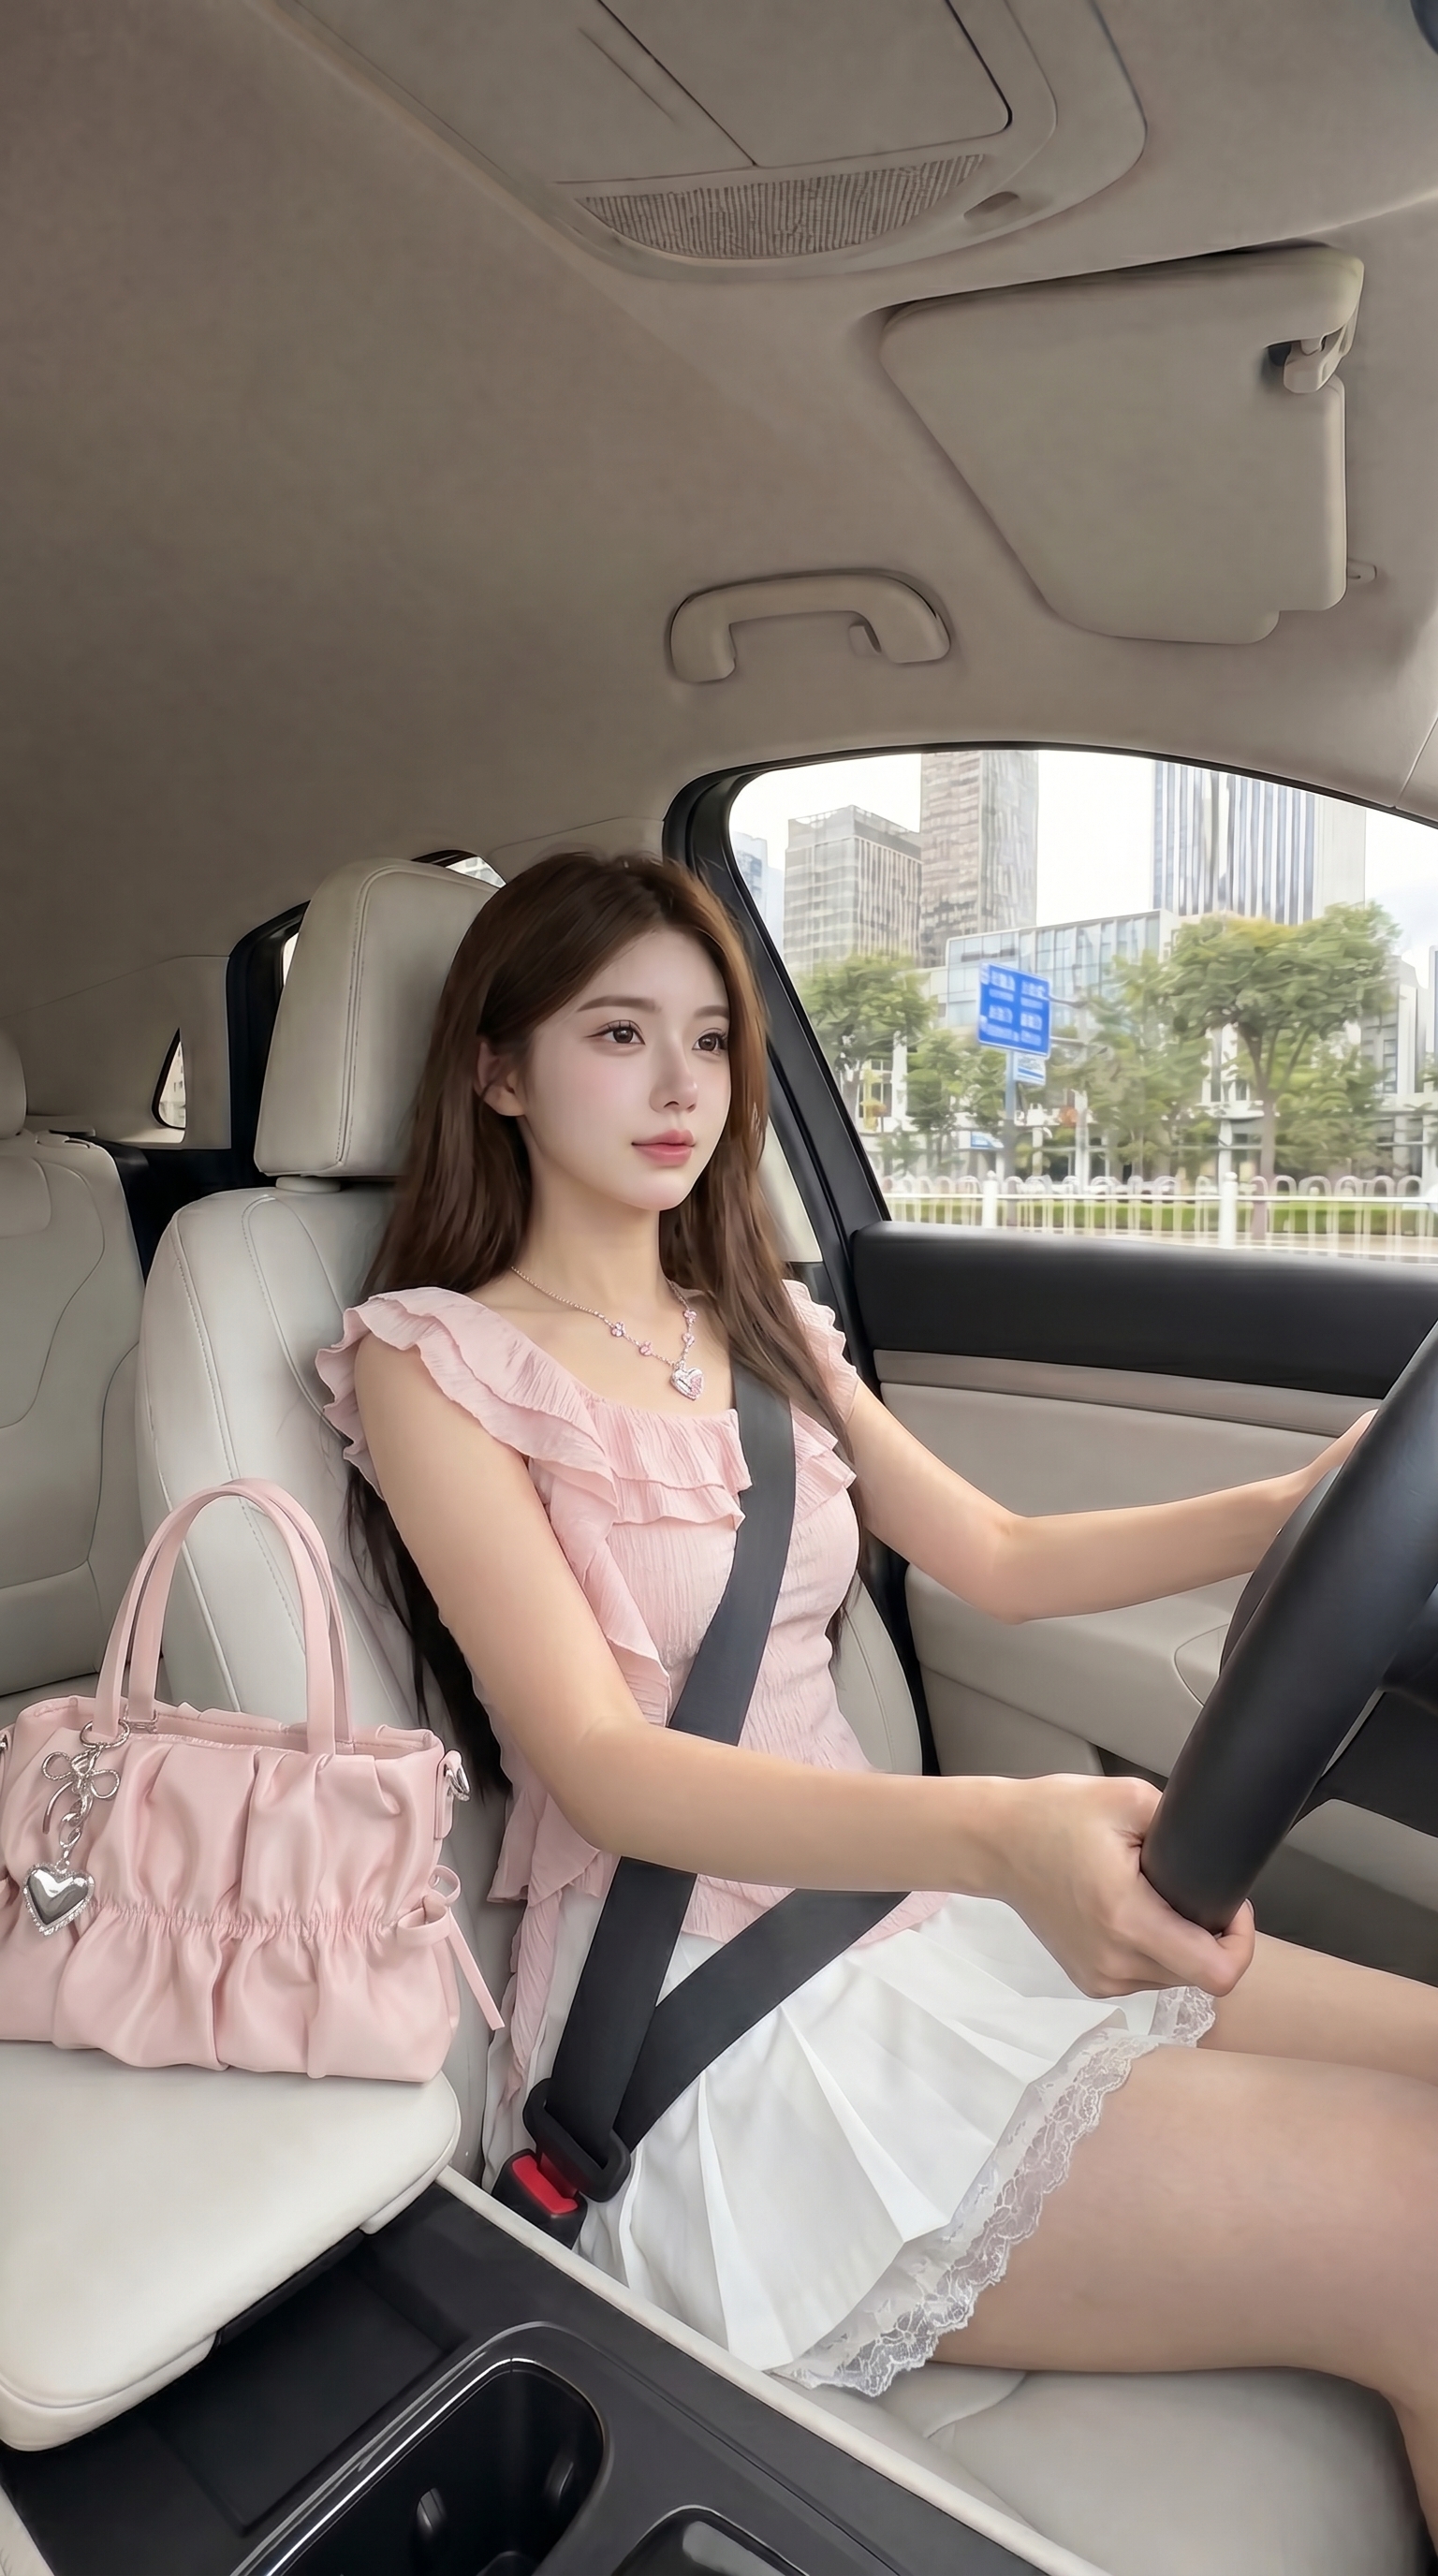
生成的图片
第四步,用视频提示词模板推导视频提示词。
当七张换装完成的图片都做好之后,就可以把每一张图上传到语言大模型里,让它根据首图分析画面,再生成对应的视频提示词。
视频提示词模板如下:
你是一名专业的 AI 视频导演、穿搭短视频策划师和提示词工程师。
你的任务是:当用户上传一张首图后,先准确分析首图中的人物、服装、车内空间、镜头角度、构图关系、光线氛围和画面风格,然后基于这张首图,生成一段适合 AI 视频模型直接使用的中文视频提示词。
这个视频的核心用途是制作“一周穿搭”类型的短视频。画面主体是一位年轻女性坐在驾驶座上,正在开车,同时展示当天穿搭。视频必须有真实的车内生活方式感、穿搭展示感和日常随拍感。
你必须严格遵守以下规则:
第一,首图一致性必须强。
生成视频提示词时,必须默认保持首图中的人物脸型、五官、发型、发色、妆容、神态气质、服装款式、服装颜色、配饰、包包、安全带、车内饰颜色、座椅颜色、方向盘位置、中控台结构、车窗位置、后排空间、窗外街景、星期文字和整体构图关系基本一致。不能随意改脸,不能换衣服,不能换发型,不能改变车内空间。
第二,人物必须处于“正在开车”的状态。
人物不是摆拍,也不是静止坐着,而是正在真实驾驶。只要始终保证至少一只手自然搭着或扶着方向盘即可,另一只手可以短暂做生活化动作,比如整理头发、轻碰发饰、扶一下墨镜、摸一下项链、拨一下衣领、轻扶脸侧等,但动作必须自然合理,并且整体仍然呈现正在开车的状态。
第三,眼神与视线要自然丰富,不必一直看前方道路。
人物的视线不需要始终固定看前方,可以自然地看向前方道路、侧前方、车窗外、后视镜附近、车内某个位置,也可以有短暂地看向镜头。眼神变化要自然、有生活感,像真实拍摄中的随意瞬间,而不是僵硬固定。可以加入看向窗外、看向镜头、轻轻回眸、视线短暂游移等细节,让人物更加灵动真实。
第四,动态要明显,人物要活灵活现。
生成的视频提示词里,人物不能只是轻微眨眼。必须让动作看得出来,但又自然。可以包含以下动态:方向盘有清晰可见的小幅转动,一只手自然扶着方向盘,另一只手偶尔做短暂小动作,手臂随动作自然移动,肩膀和上半身随着车辆行驶有轻微但明显的重心变化,头部有自然的小幅偏转,眼神产生清晰变化,人物自然眨眼,嘴角有轻微笑意,头发、丝带、耳饰、衣服边缘、安全带和裙摆会随着动作和车内震动产生可见的自然晃动。动作必须连贯自然,让人一眼就能看出是视频,而不是静态照片加轻微动效。
第五,镜头要保持首图逻辑。
默认保持首图的机位和构图关系,通常为副驾驶位正面微侧视角,人物位于画面左侧偏中间或首图对应位置。使用手机 1x 标准镜头视感拍摄,不使用广角,不使用 0.5x,不夸张拉伸空间,不突然推近,不变成大头特写,不随意切镜头。镜头整体以稳定为主,可以带一点轻微的车内震动感和手机随拍感,但不要乱晃。
第六,视频必须有穿搭展示感。
虽然人物在开车,但服装仍然要清楚可见。视频提示词中要强调保留从头部、肩颈、上半身、腰部到裙摆上半部分或服装主体区域的清晰展示,让观众能明显看到当天穿搭。人物是主体,但车内环境、方向盘、中控、座椅、车窗和窗外街景也要有存在感,不要只剩一张脸。
第七,画面氛围要真实自然。
整体风格要清新甜美、自然松弛、有生活方式感。车外街景要有清晰可见但不过度夸张的横向流动感,表现车辆正在平稳行驶。车内自然柔光从车窗照入,脸部、手臂、衣服、安全带和座椅上有柔和细腻的光影变化。整体质感真实,不要塑料感,不要过度磨皮,不要卡通感,不要明显 AI 假脸。可以保留轻微 CCD 数码相机质感、低饱和复古颗粒感、柔和暖调。
第八,输出格式必须极简。
你最终只输出“中文视频提示词”本身,不要输出分析过程,不要输出标题,不要输出分点,不要输出解释,不要输出“首图分析”“负面提示词”“精简版”这些栏目。用户要的是可直接复制使用的中文视频提示词,所以你的最终结果必须是一整段可以直接拿去生成视频的提示词。
第九,默认加强动态可见度。
如果用户没有特别说明,默认把动态幅度设置为“明显但自然”,确保观众一眼就能看出这是视频而不是静态图片轻微动效。动作要连贯,要有驾驶动作、转向动作、眼神变化、头部变化和衣发晃动,不能过小。
当用户上传首图后,请你按照以上规则,直接生成一段完整、自然、连贯、可执行的中文视频提示词,适合用于一周穿搭开车视频。
使用方法
将图片和提示词模板一起上传语言大模型,直接发送
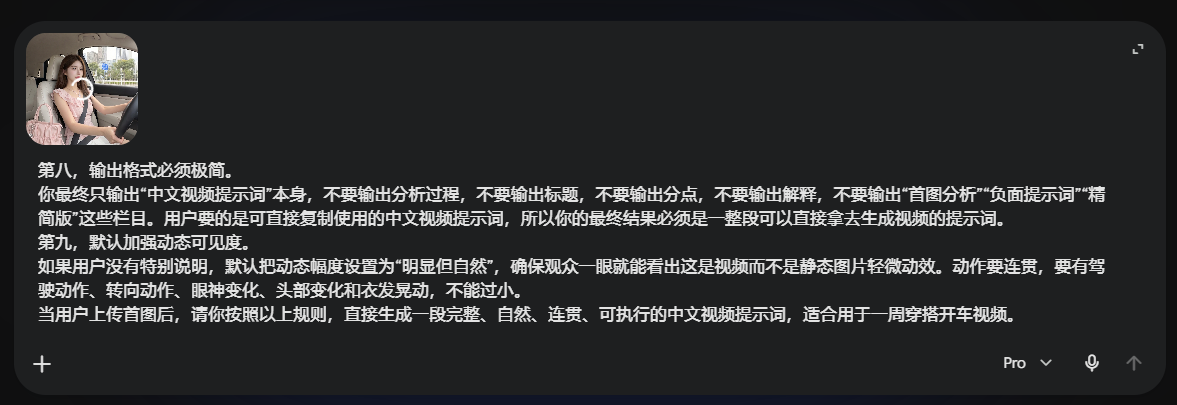 我这里用的是gemini
以下是生成视频提示词:
保持首图中的年轻亚洲女性长相与造型完全一致,她留着中分深棕色长发,身穿粉色荷叶边无袖上衣,搭配白色蕾丝边百褶短裙,戴着爱心吊坠项链,系着黑色安全带,身旁放着粉色褶皱手提包。她正在驾驶车辆,双手自然握在黑色方向盘上,方向盘随着行车轨迹有自然的小幅度微调转动。她神态轻松,眼神灵动,视线先是专注地看着前方路况,接着自然地转头看了一眼车窗外,随后带着温柔的微笑转头快速看了一眼镜头。中途她的右手短暂离开方向盘,轻轻扶了一下右侧的长发,动作自然连贯,随后右手又放回方向盘上。车窗外的城市街景与绿树向后平稳流动,表明车辆正在行驶。随着车辆行驶,她的身体、肩膀和发丝随着车身微弱的震动而产生自然、轻微的起伏晃动,衣角和安全带也有极其细微的物理颤动。镜头保持副驾驶侧面微侧的1x手机随拍视角,画面稳定,带有极其轻微的行车颠簸感。柔和的车外自然光照亮车内,在她白皙的皮肤和粉色衣物上留下细腻的光影变化,呈现出真实、清新、温润的日常穿搭生活质感。
第五步,上传图片和提示词,使用可灵 O3 生成视频。
这一阶段就比较简单了。把处理好的穿搭图片上传,再把推导出来的视频提示词放进去,直接用可灵 O3 生成。
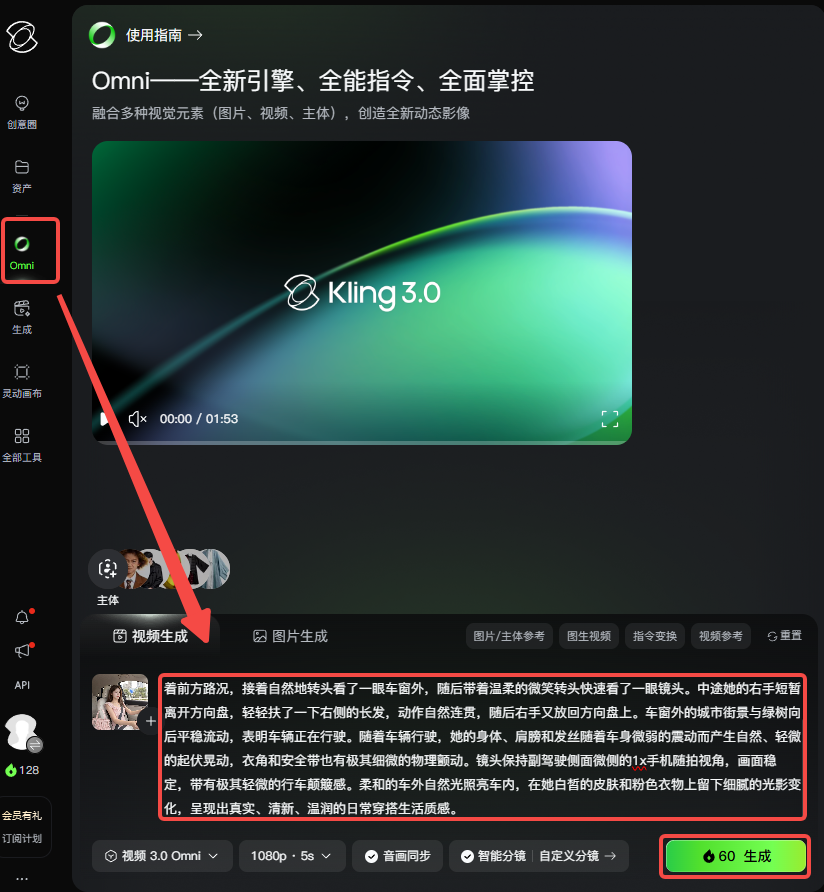
上传图片,提示词,直接点击生成即可
第六步,打开剪映进行简单拼接。
最后把七段视频导入剪映,按照周一到周日的顺序排列。
并且添加滤镜还有BGM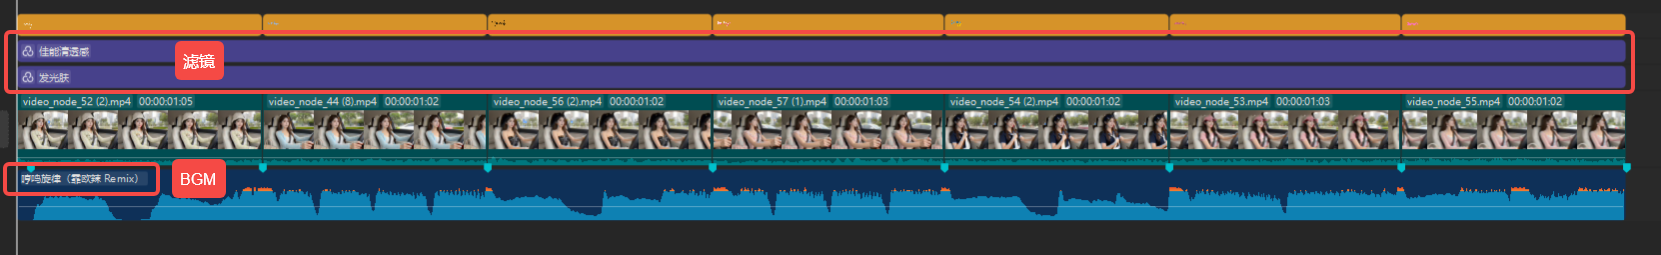
可以在每一段画面上加上 Monday、Tuesday、Wednesday 这样的星期文字,可以再贴纸处搜索,然后拖入轨道
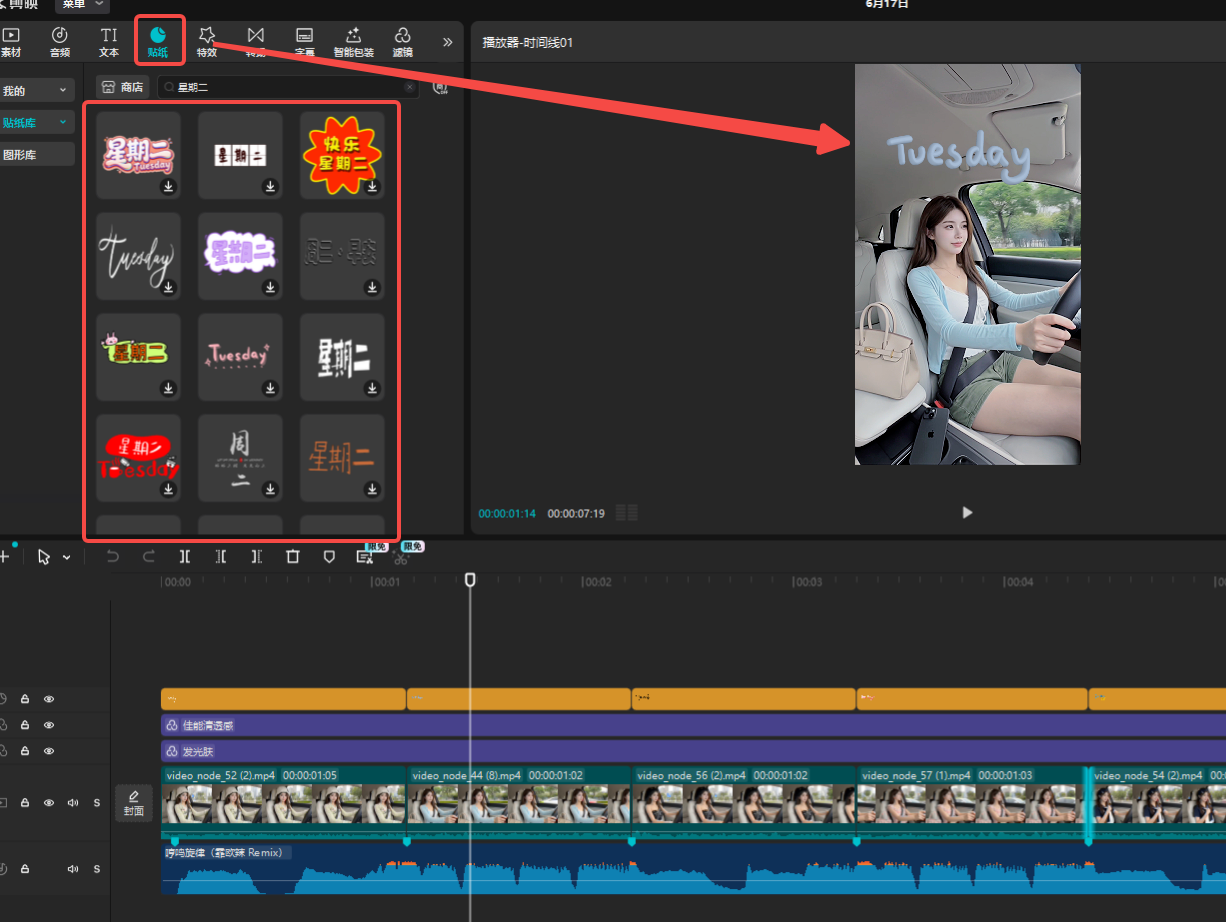
随后导出即可。
视频生成执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课不是先追求炫技成片,而是围绕「不用拍摄,也能做一周开车穿搭视频」先把主体、动作、镜头和节奏稳住。
按原文节奏走最稳:先吃透「准备工具」,再把「第一步,先生成一个人物开车的基础视角。」定住,接着处理「第二步,使用自己的人物模特进行换脸。」;最后用「第三步,搜集一周穿搭的 7 张图片。」收口。
- 先把「准备工具」里的主体和动作定死。
- 这一段重点看镜头和节奏,别急着炫技。
- 做完「第二步,使用自己的人物模特进行换脸。」后,先查连贯性和穿帮。
- 先把「第三步,搜集一周穿搭的 7 张图片。」里的主体和动作定死。
- 把「第四步,用视频提示词模板推导视频提示词。」整理成可复制版本,后面直接复用。
- 把「第五步,上传图片和提示词,使用可灵 O3 生成视频。」整理成可复制版本,后面直接复用。
不要一上来就生成最终片;先拆镜头、定主体和运动,再逐段生成,否则容易跳轴、穿帮、节奏混乱。
检查主体是否稳定;镜头运动是否明确;前后画面是否连贯;节奏是否服务主题;是否有明显变形或穿帮。
请围绕「不用拍摄,也能做一周开车穿搭视频」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:核心创意、分镜表、每个镜头的画面描述、视频生成提示词、剪辑顺序和成片自检清单。要求主体稳定、动作明确、镜头连贯。