在AI创作的进阶之路上,局部控制力是区分新手与高手的核心分水岭。
很多创作者发现,现在最让人头疼的不是怎么写提示词,而是在不破坏原画面的前提下,去替换里面的某个元素。
本节课将直击痛点,教你如何在不动整体电影感光影的情况下,利用2026年主流的AI工具,实现精准且自然交融的元素替换。
第一章:为什么你改的提示词,AI总是“听不懂”且融入差?
在学习具体的方法之前,我们必须先理清一个底层的逻辑。很多创作者在修改画面时,
最直觉的做法就是:直接在原有的提示词里加上修改指令,或者把不要的词换掉。
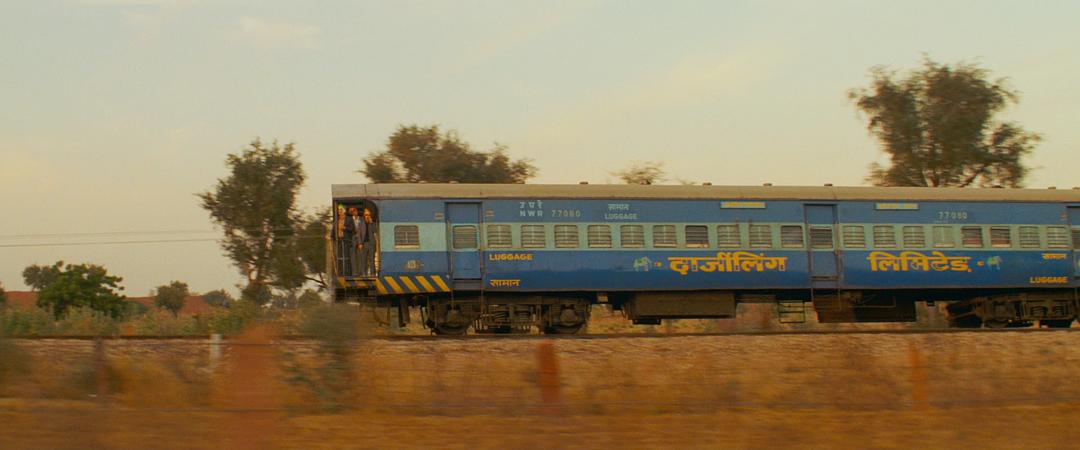
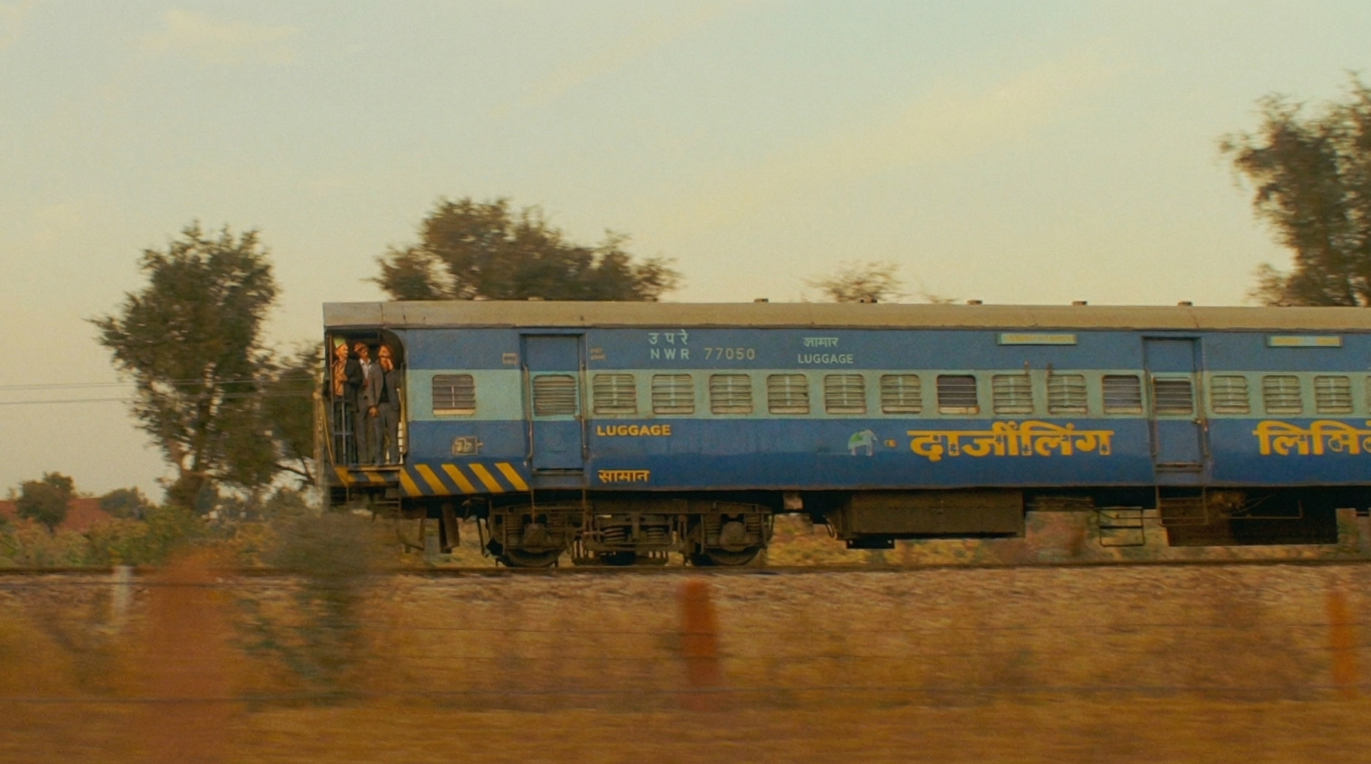
原画面拥有极强的暖调电影感光影与真实的动态模糊。
比如上面这段极具复古电影感的火车视频。
你现在的需求是:保持所有背景、光影和镜头运动不变,仅仅把这辆真实的蓝色火车,替换成经典的“托马斯小火车”。
如果你直接把视频丢进可灵的V3 omini 模型(或者其他视频大模型),
并输入提示词:“把火车换成红色的托马斯火车”。你会发现一个让人崩溃的现象:
替换出来的托马斯火车极其虚假,画面毫无融入感!
这背后的原因在于:当你直接输入“托马斯火车”时,AI的语言大模型会立刻联想到它训练库里海量的儿童动画片数据。那些数据大多是明亮的纯色、扁平的3D材质、毫无复杂光影的。AI无法在极其有限的视频重绘算力下,凭空将一个“低龄卡通形象”瞬间脑补成“带有现实主义电影级光影”的实体。
因此,精准替换的本质,不是单纯地改写提示词,而是要分步骤地给AI提供精准的光影材质参考。我们要先造一个“电影级的托马斯”,再让它动起来。
第二章:跨次元替换核心法 —— 参照物定调法(解决虚假感)
对于这种替换前后画风差异极大、且目标物体处于相对独立运动状态的情况,最正确的做法是:先用单图确立“视觉材质锚点”,再用该锚点指导视频生成。
步骤一:制作“完美参考图(光影定调)”
1.从原视频中截取一张视频的首帧图
步骤二:利用 Nano Banana Pro 进行局部重绘
将这张图导入到图像编辑能力顶尖的 Nano Banana Pro 中
直接输入提示词:
把火车换成红色的托马斯火车
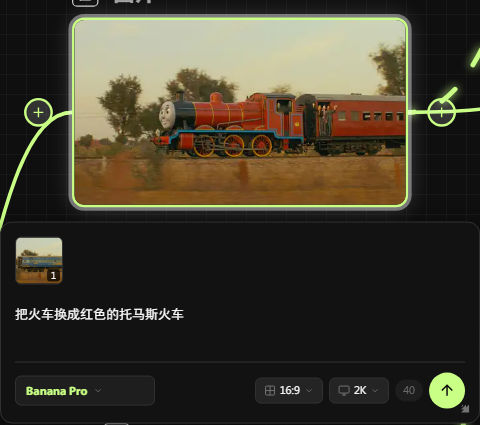
如此一来,蓝色的火车自然而然地被托马斯火车所取代。
步骤三:带参考图进行视频重绘
现在,我们进入视频生成工具。推荐使用对图像参考权重执行度极高的 即梦AI,或者继续使用 可灵 o mini 的多图参考模式。
在可灵3.0 Omini模型生成工具中,上传你原始的视频与修改后的图片
输入提示词:
把视频中的火车改成图片中的火车
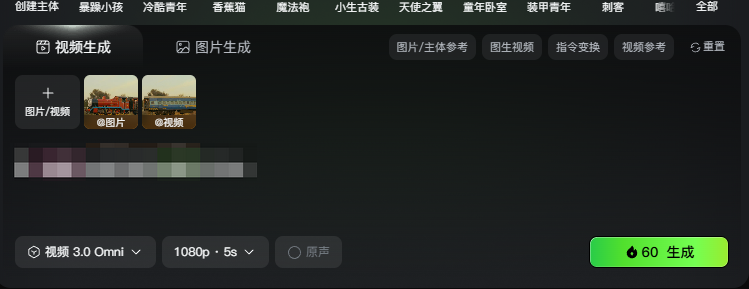
点击生成。
方法总结:
通过给AI一张已经修改好的静态图作为“视觉标准答案”,AI在重新计算视频每一帧时,就有了明确的对比目标。
它不再需要去猜测“红色的火车”到底长什么样、放在哪里,而是直接把参考图里的红色火车“贴”进视频的运动轨迹中,从而保证了视频的极度稳定。
第三章:极致细节控制法 —— 静帧遮罩法(高精度逐帧控制)
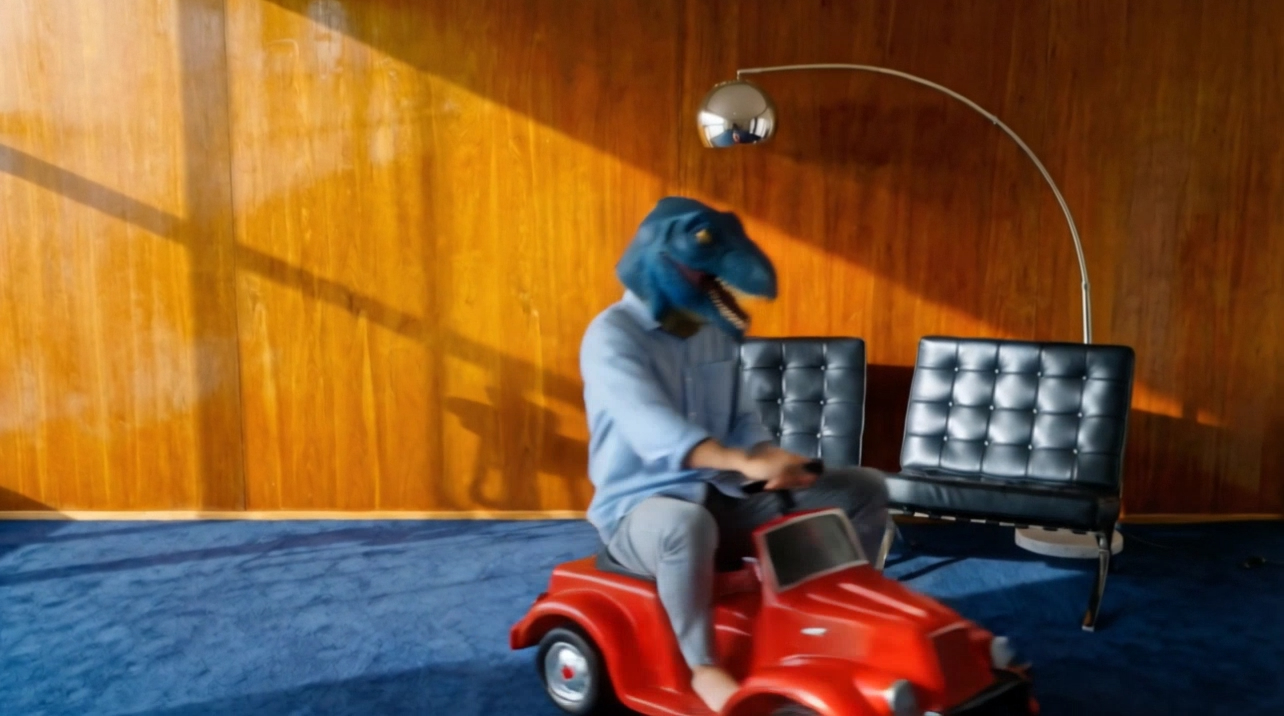
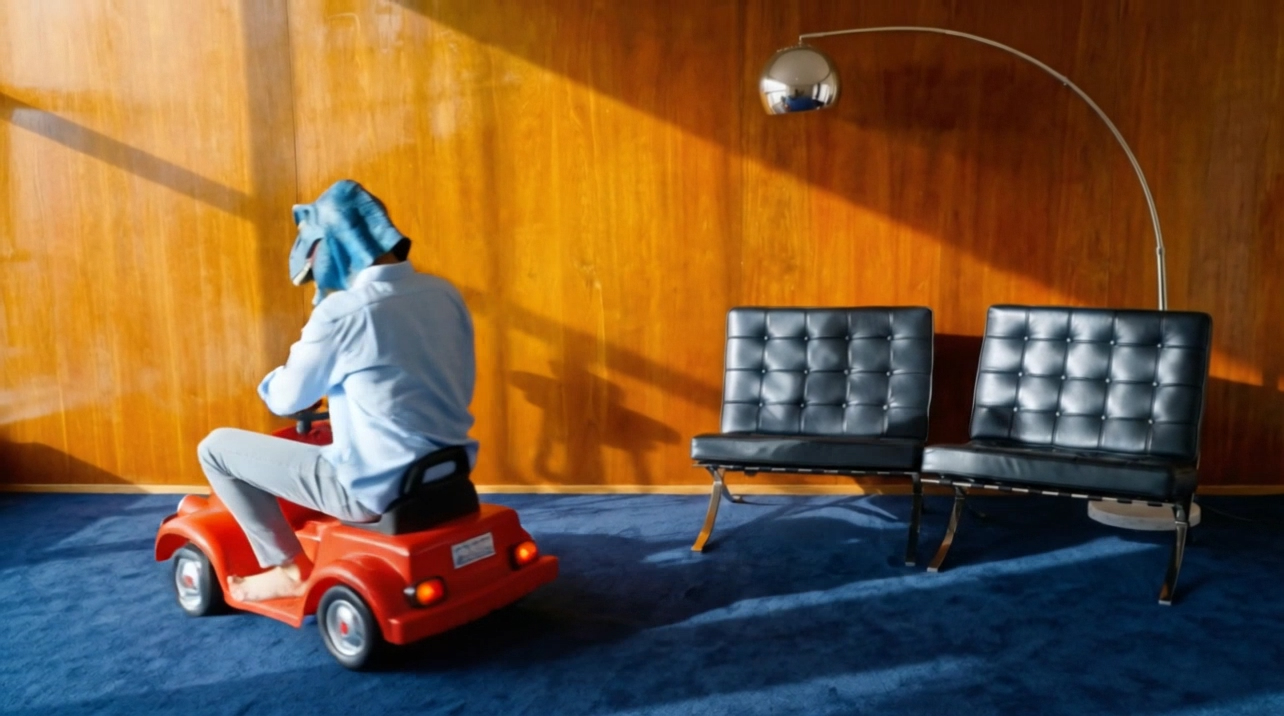
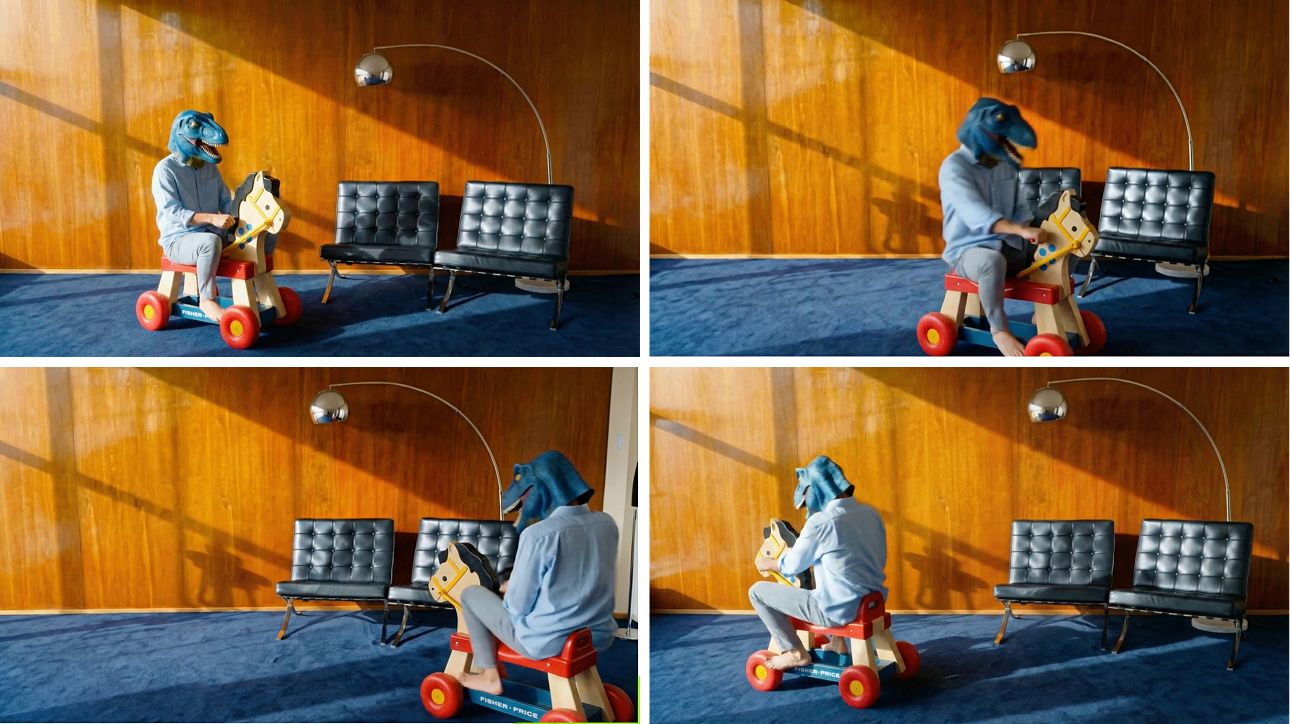
视频里的恐龙人是骑着车在拐弯的(从侧面转到了背面)。
我们不仅要替换成这个特定的玩具马车,还要保证它在视频转向时不穿帮、不融化。
遇到这种有着复杂受光面变化和大角度运动的物体,单图定调法在中间帧一定会崩。我们必须使用“极致细节控制法(多图批量约束)”。
它的逻辑是:把你手里这唯一视角的玩具马车参考图,结合视频的不同关键帧,强行“画”出它在不同角度的样子,再交由视频生成工具重新驱动。
步骤一:提取大动态轨迹关键帧
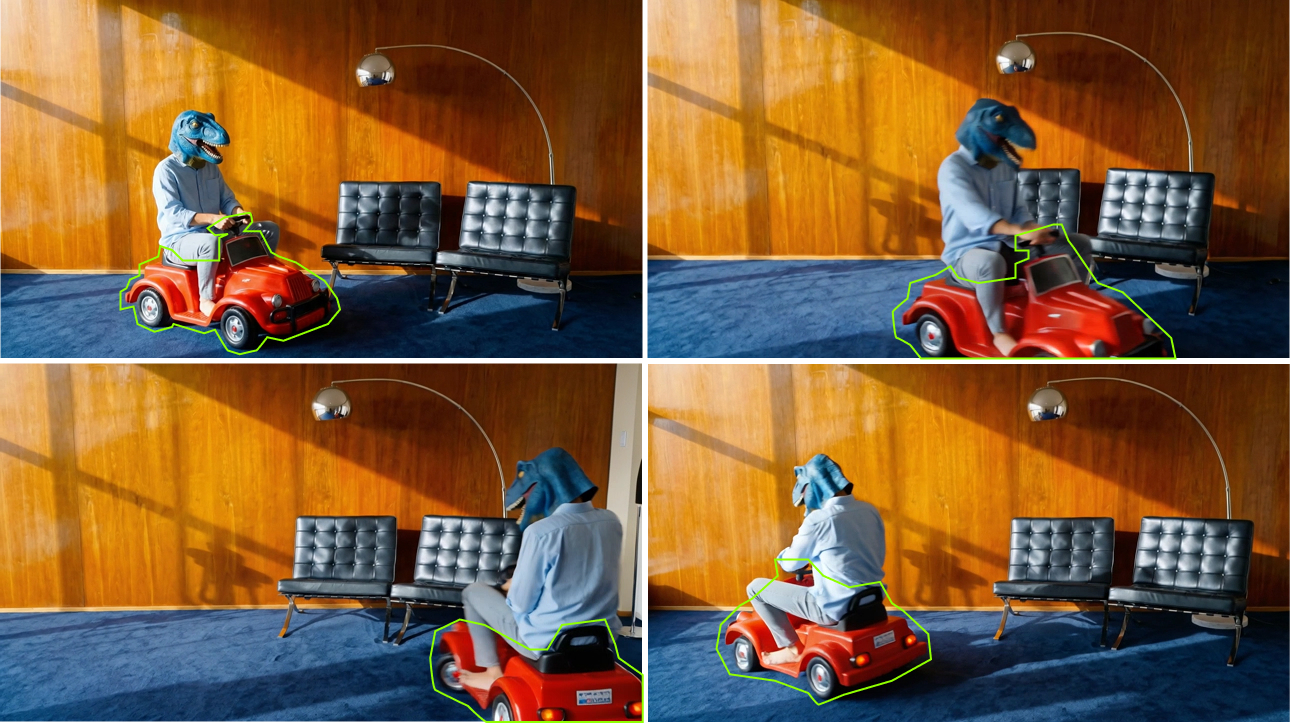
提取视频的4张核心关键帧:
起步侧视(00:00)
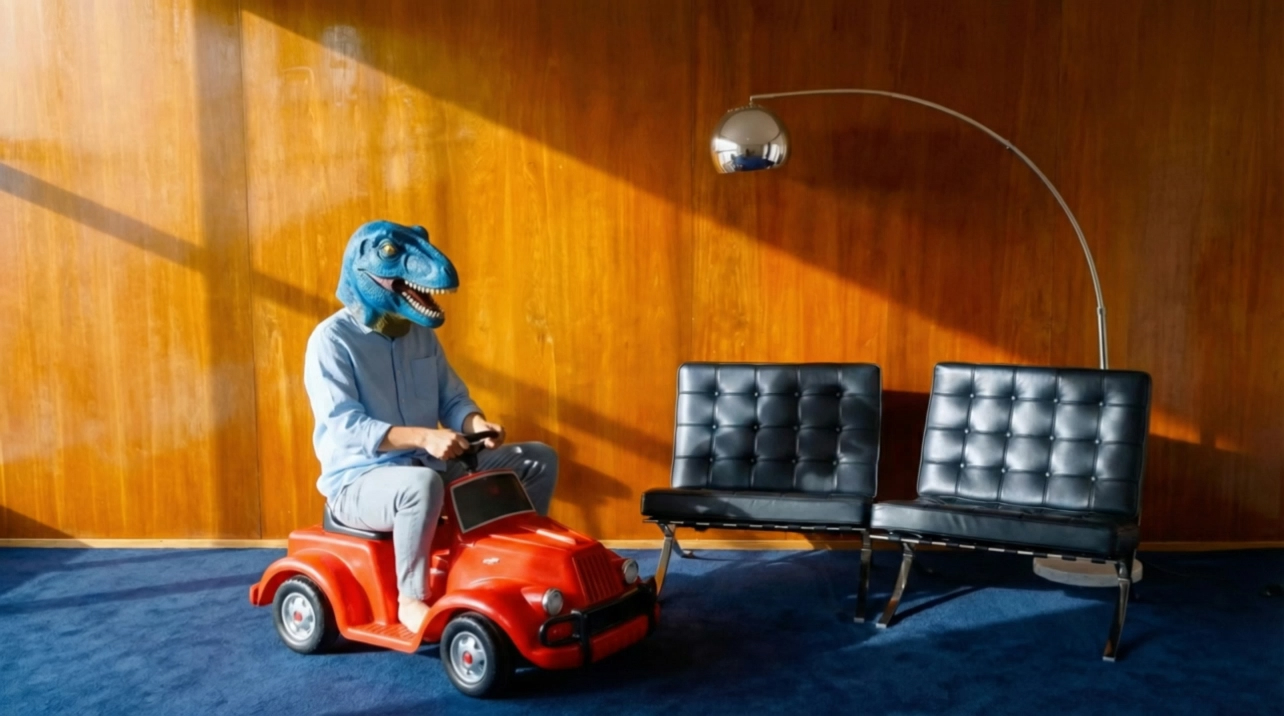
开车中途(01:00)
转向中途(00:02)
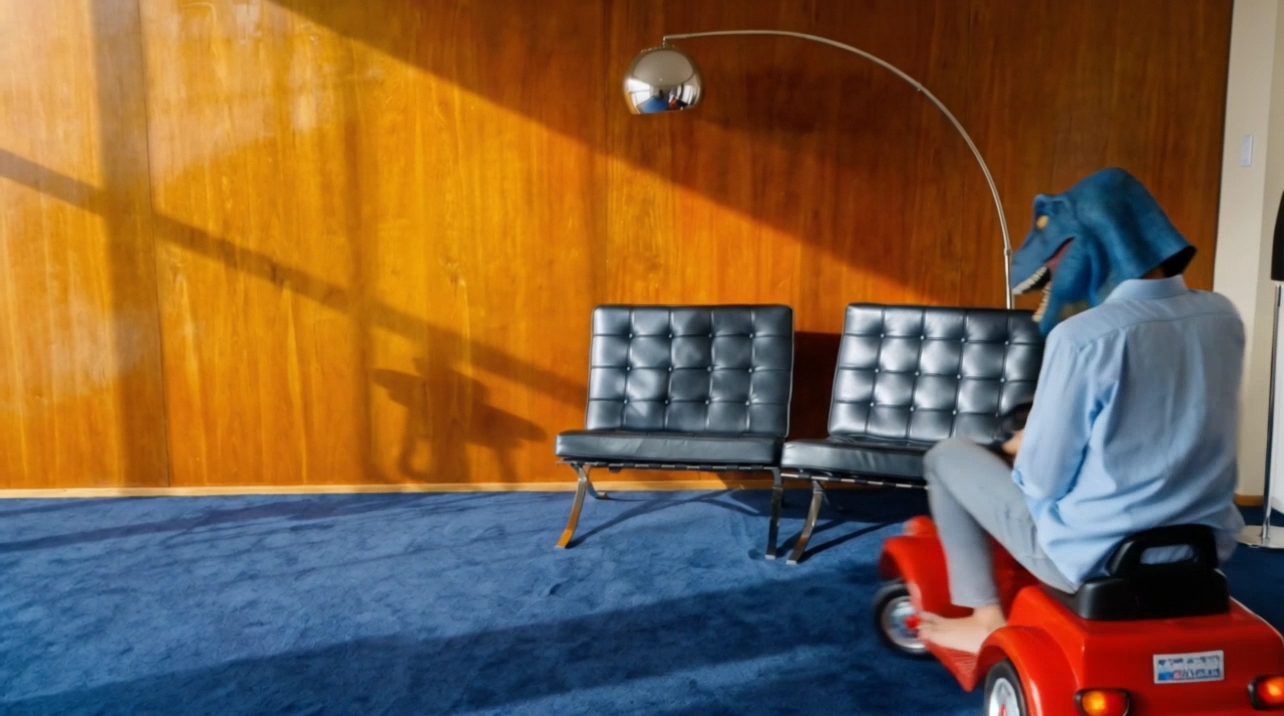
背向行驶(00:04)
步骤二: 使用设计软件将玩具车画出蒙版
步骤三: Nano Banana Pro 逐帧多角度定调
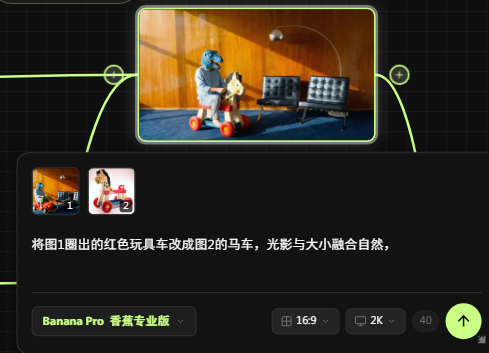
将蒙版图与马车图交给banana pro进行图生图
提示词:
将图1圈出的红色玩具车改成图2的马车,光影与大小融合自然,
步骤四:可灵 3.0 omini 驱动多图参考
1.打开可灵AI 3.0 omini
2.将视频与更改马车的图片按照顺序拖入
输入提示词:
参考视频1,将视频中的玩具车替换,按顺序遵循图片1图片2图片3图片4的序列帧
3.点击生成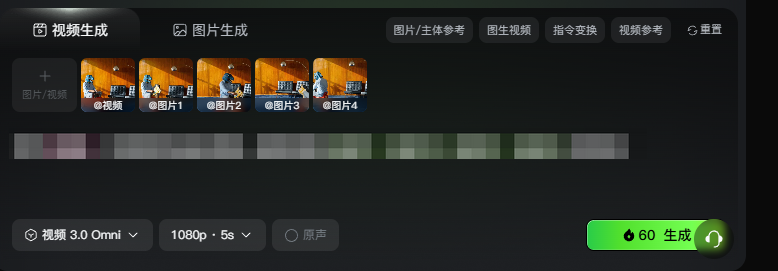
结语
高阶的精准替换,比拼的不是谁会用更生僻华丽的提示词,而是
谁更懂物体运动规律和AI底层算力的局限性。
下次当你发现视频里的物体转个弯就变形,或者改出来的东西像粗劣的拼贴画时,不要死磕一句全局指令。
退回一步,学会提取关键帧,运用图像参考和多角度遮罩,给AI制定明确的空间范围和多视角路标。只要你控制了变化过程的节点,AI就会变成你手中听话的电影级特效师。
视频生成执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课不是先追求炫技成片,而是围绕「告别生硬替换:AI视频与图像局部元素的融合指南」先把主体、动作、镜头和节奏稳住。
按原文节奏走最稳:先吃透「第一章:为什么你改的提示词,AI总是“听不懂”且融入差?」,再把「第二章:跨次元替换核心法 —— 参照物定调法(解决虚假感)」定住,接着处理「第三章:极致细节控制法 —— 静帧遮罩法(高精度逐帧控制)」;最后用「结语」收口。
- 把「第一章:为什么你改的提示词,AI总是“听不懂”且融入差?」整理成可复制版本,后面直接复用。
- 先把「第二章:跨次元替换核心法 —— 参照物定调法(解决虚假感)」提到的误区排掉,别踩同一坑。
- 做完「第三章:极致细节控制法 —— 静帧遮罩法(高精度逐帧控制)」后,先查连贯性和穿帮。
- 先把「结语」里的主体和动作定死。
不要一上来就生成最终片;先拆镜头、定主体和运动,再逐段生成,否则容易跳轴、穿帮、节奏混乱。
检查主体是否稳定;镜头运动是否明确;前后画面是否连贯;节奏是否服务主题;是否有明显变形或穿帮。
请围绕「告别生硬替换:AI视频与图像局部元素的融合指南」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:核心创意、分镜表、每个镜头的画面描述、视频生成提示词、剪辑顺序和成片自检清单。要求主体稳定、动作明确、镜头连贯。