AI工具已经进化到了令人咋舌的地步。无论是Google的 Nano Banana Pro 在图像生成的精细度上,还是 Sora、即梦AI、可灵、海螺在视频生成的连贯性上,都已经极大降低了技术门槛。
但即便工具再强,我发现依然有90%的人卡在第一步——“开口难”。 你脑子里有一个绝美的画面,但当你面对那个闪烁的光标时,你感到大脑一片空白,或者写出来的东西AI完全理解不了。你以为是自己英语不好,或者是词汇量不够,其实不是。
这本身就是一种“反人性”的操作。人类的思维是感性的、模糊的、碎片化的,而AI需要的是理性的、具体的、结构化的指令。
今天,我们就用这套“逆向对话三步法”,彻底解决这个问题。我们不再把AI当成许愿机,而是把它当成你的“视觉合伙人”。
第一阶段:反客为主——让AI来“采访”你
核心心法:灵感不等于提示词,必须先被具象化。
很多人拿到工具(比如打开Midjourney或者即梦AI),第一反应是自己拼命想词:“高画质、美女、宫崎骏风格、唯美……” 然后生成出来的图,千篇一律,毫无灵魂。
因为你只有“感觉”,没有“语言”。你无法描述那个午后阳光洒在书页上的具体质感,也无法描述微风吹动窗帘的动态幅度。
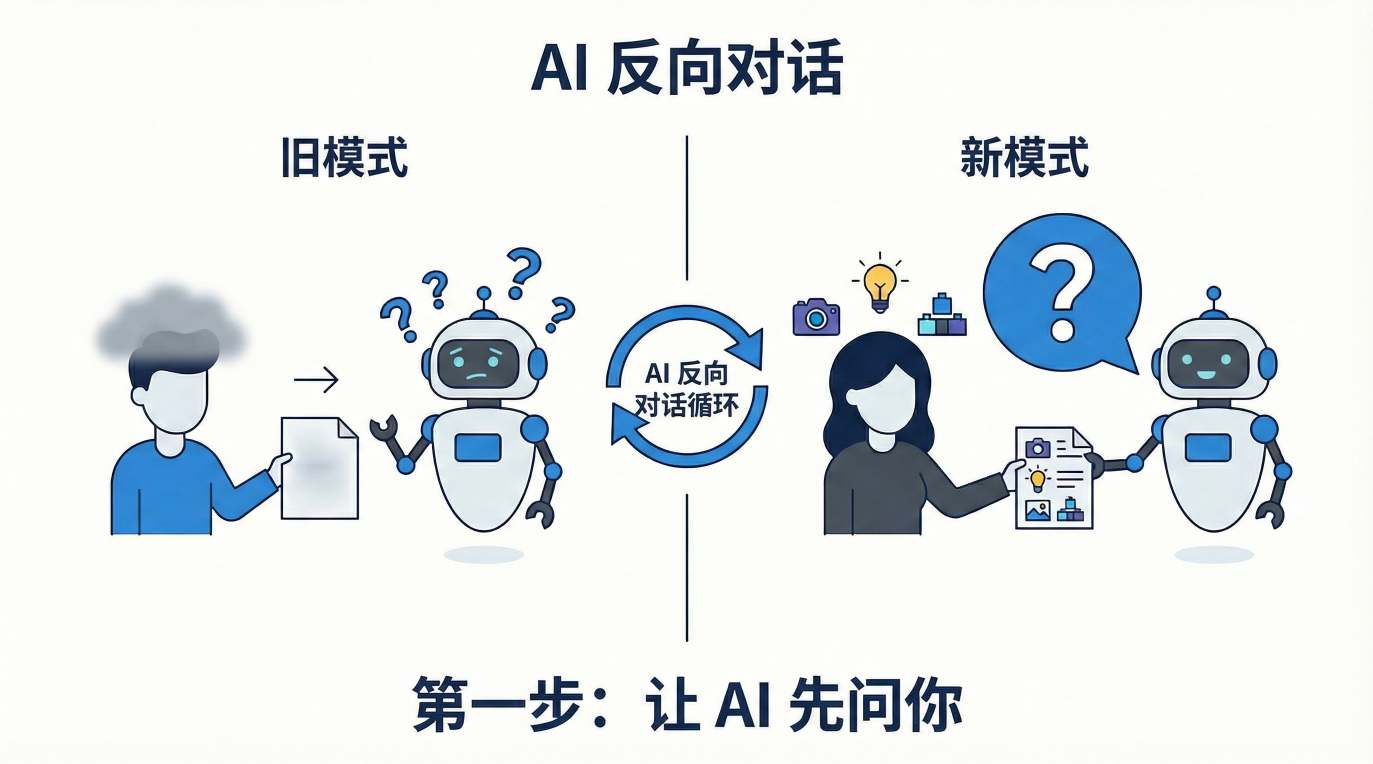
正确做法:不要你去引导AI,而是让AI来引导你。
现在的AI模型(如Gemini 3.0 Pro, GPT-5等)理解能力极强。你可以把它们当作一个专业的“摄影导演”。
1.1 启动“采访模式”
不要直接写画面,先输入这样一段指令给你的语言大模型(如Gemini):
Prompt:
“我现在脑子里有一个模糊的画面/感觉,我想生成一张图片(或一段视频)。但我不知道怎么描述细节。请你扮演一位顶级的视觉艺术总监,你需要从镜头语言、构图方式、主体细节、光影色调、艺术风格这几个维度,向我提问。请一个个问题问我,引导我把脑子里的画面具象化。”
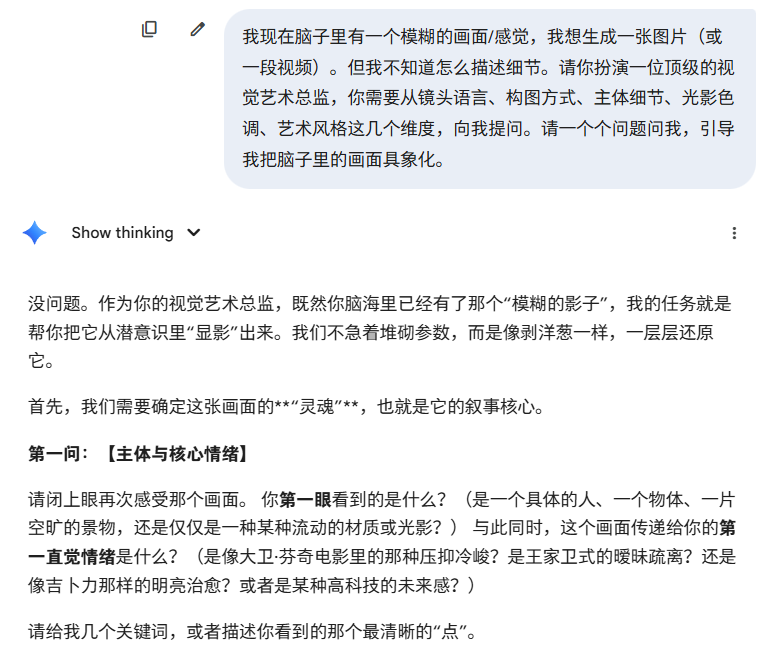
我使用的是gemini3pro,豆包和chat gpt都可以
1.2 感觉转译实战(案例演示:治愈系午后)
当你输入上述指令后,AI会开始问你。
第一问
你觉得:
“我想要一种很温暖,很安静,有点像童年回忆的感觉。”
AI会问:
第二问:【镜头语言与观察视角】
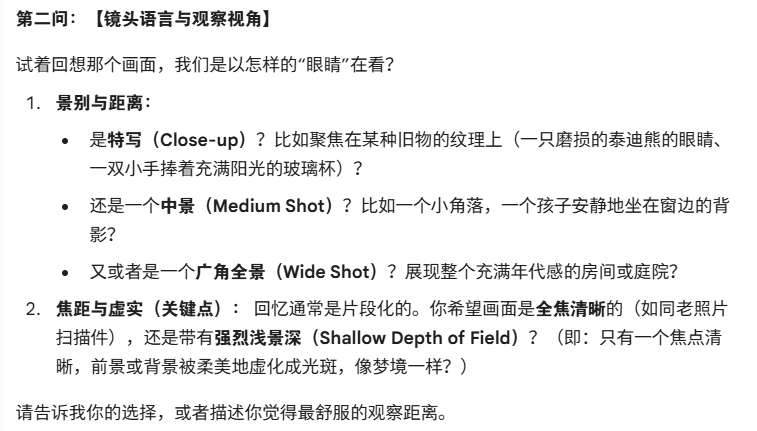
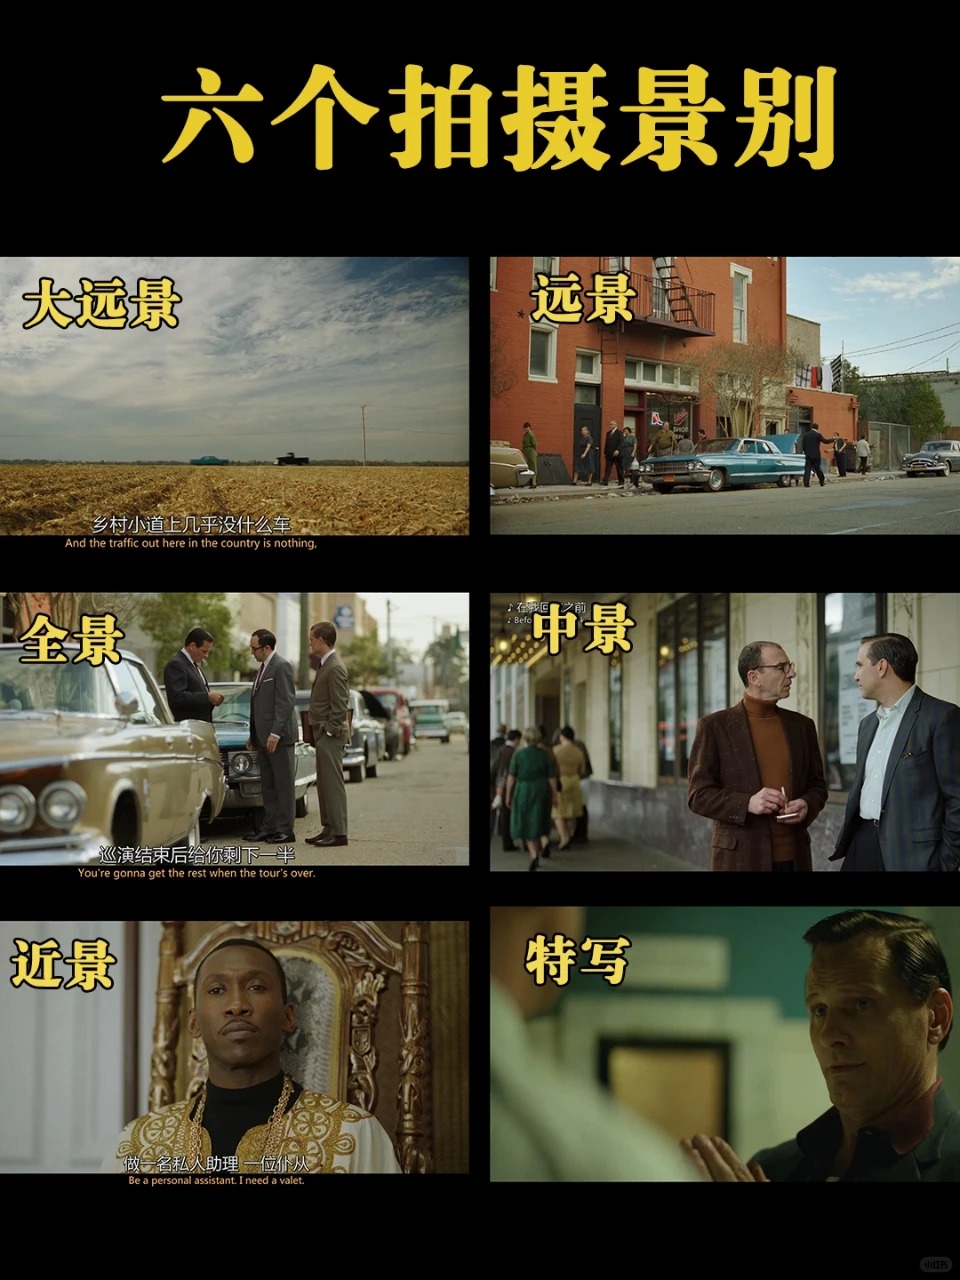
景别参考
这就是关键点! 细节你很难凭空捏造,但在AI的追问下,做“选择题”是很容易的。
此时直接回答
我要中景的镜头
第三问
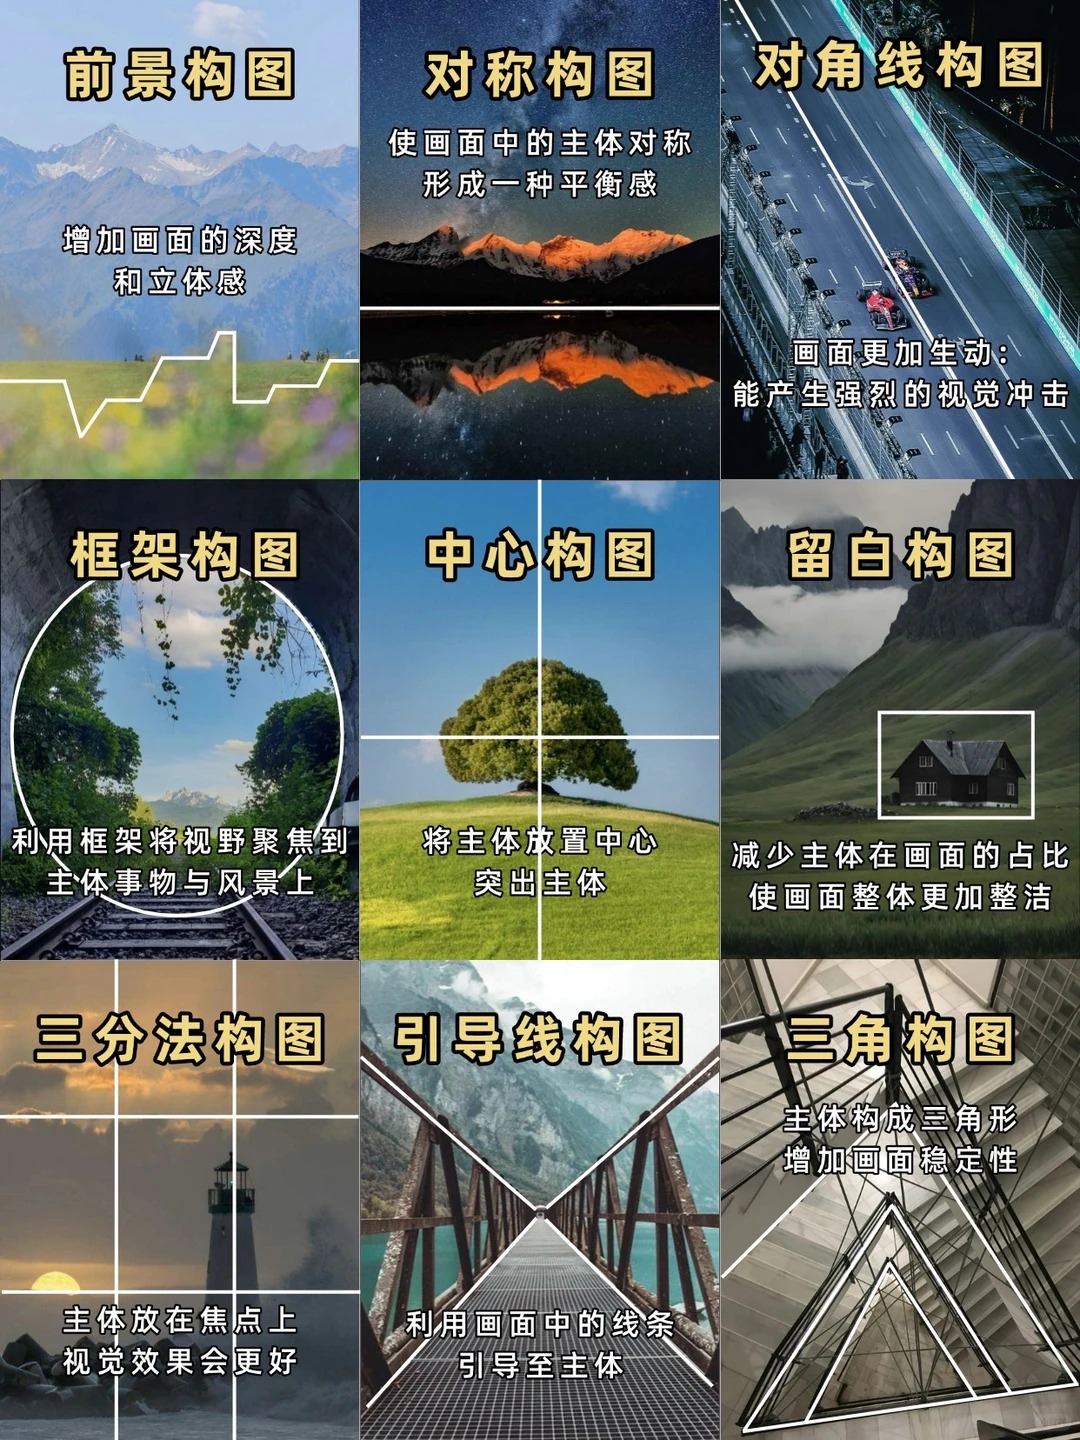
构图参考
直接回答
框中框构图
第四问:【主体细节——前景之“框”与景中之“画”】
继续回答
前景的“框”是一扇半开的旧木门或窗棂,框里的“画”是小孩
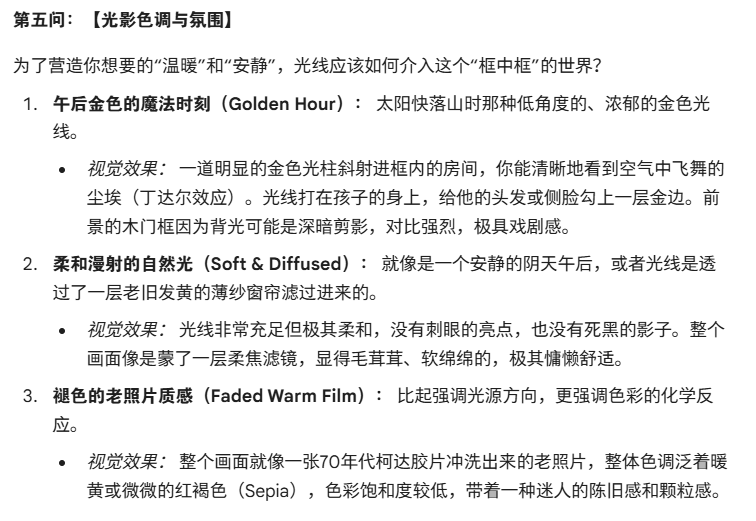
第五问:【光影色调与氛围】
继续回答:
柔和漫射的自然光
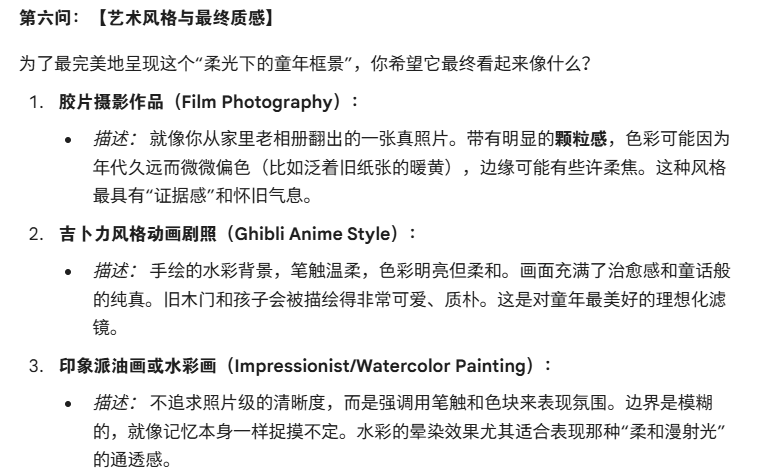
第六问:【艺术风格与最终质感】
继续回答:
胶片摄影作品
画面蓝图
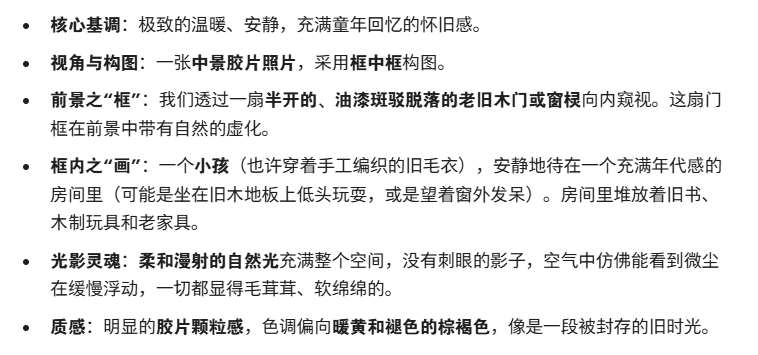
通过这轮“反向采访”,你实际上完成了一次从“情绪”到“视觉参数”的解码。
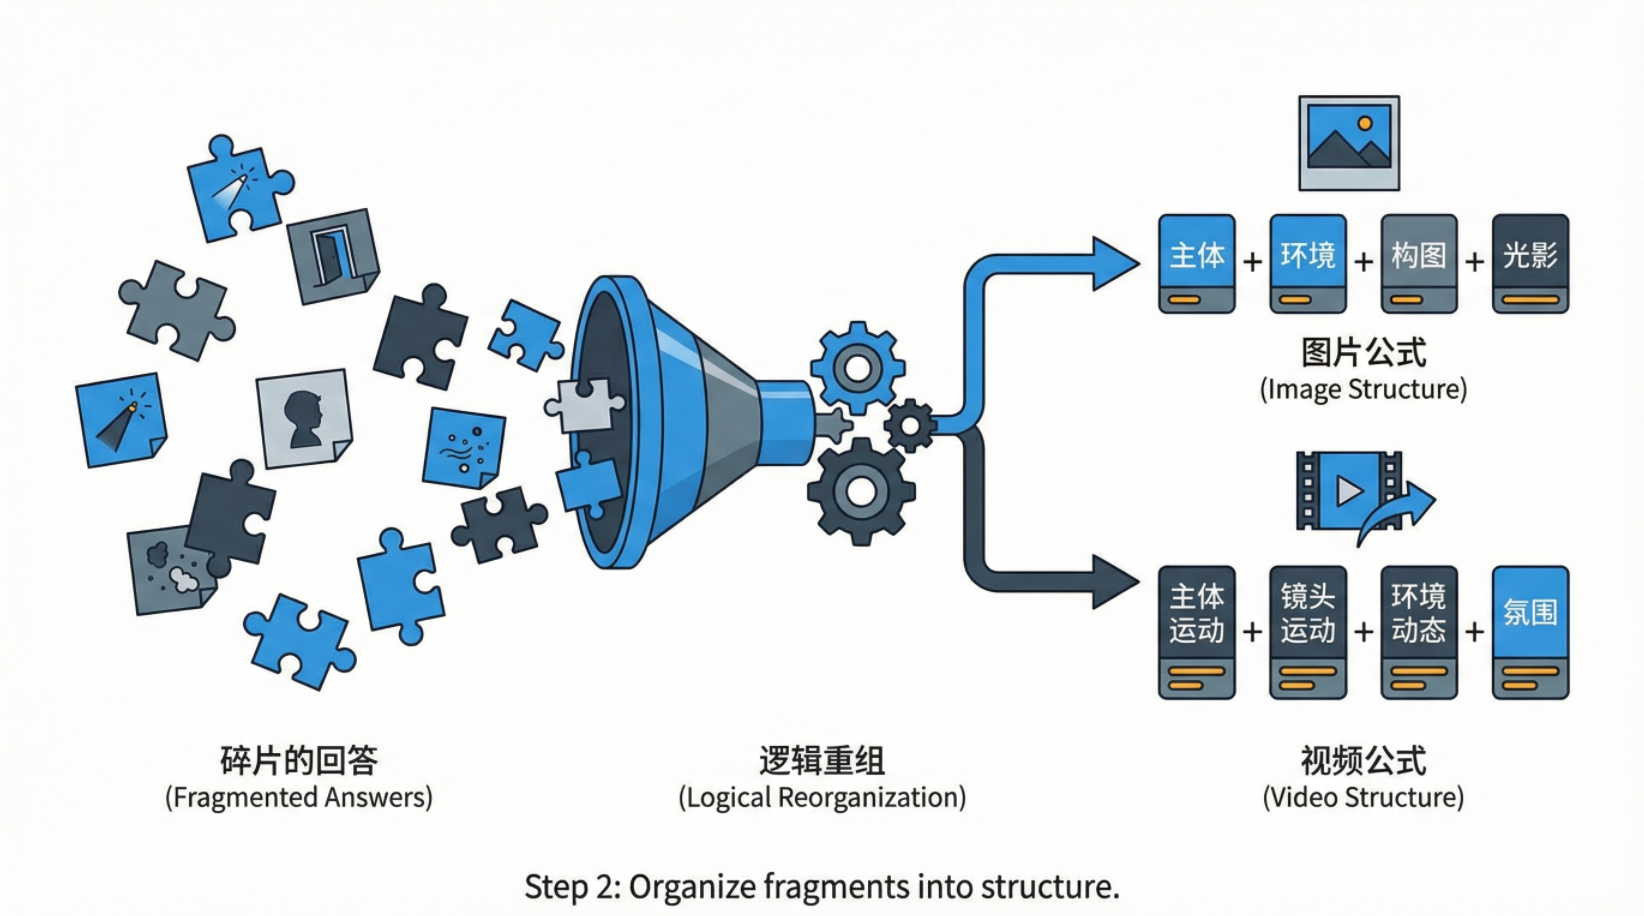
第二阶段:逻辑重组——把问答碎片变成“可执行代码”
核心心法:我们做的不是生成,而是整理。
在第一步结束后,你得到了一堆碎片信息:
核心基调:极致的温暖、安静,充满童年回忆的怀旧感。
视角与构图:一张中景胶片照片,采用框中框构图。
前景之“框”:我们透过一扇半开的、油漆斑驳脱落的老旧木门或窗棂向内窥视。这扇门框在前景中带有自然的虚化。
框内之“画”:一个小孩(也许穿着手工编织的旧毛衣),安静地待在一个充满年代感的房间里(可能是坐在旧木地板上低头玩耍,或是望着窗外发呆)。房间里堆放着旧书、木制玩具和老家具。
光影灵魂:柔和漫射的自然光充满整个空间,没有刺眼的影子,空气中仿佛能看到微尘在缓慢浮动,一切都显得毛茸茸、软绵绵的。
质感:明显的胶片颗粒感,色调偏向暖黄和褪色的棕褐色,像是一段被封存的旧时光。
如果你直接把这些词扔给视频生成工具(如可灵或海螺),画面很可能有问题。因为碎片之间没有逻辑关联。我们先进行逻辑重组,随后先生成图片,再通过图片生成视频。
2.1 图片生成逻辑(针对 Nano Banana Pro / Midjourney)
对于静态图像,核心是“凝固的瞬间”。你需要构建的是空间关系。
万能公式: [主体描述] + [环境背景] + [构图与视角] + [光影与色调] + [风格/渲染引擎]
[主体描述] 一个安静的小孩坐在陈旧的木地板上,穿着复古的手工编织毛衣,正在玩一个简单的玩具,侧脸,神态宁静,
[环境背景] 在一个充满怀旧感的房间里,斑驳的墙壁,背景有老式家具,空气中漂浮着尘埃,
[构图与视角] 中景镜头,框中框构图,透过前景一扇半开的、油漆剥落的老旧木门缝隙向内看,前景门框自然虚化,制造出窥探回忆的纵深感,
[光影与色调] 柔和漫射的自然光,温暖的朦胧感,丁达尔效应,没有刺眼的阴影,怀旧的暖黄和褪色棕褐色调,
[风格/渲染引擎] 胶片摄影风格,柯达Portra 400质感,明显的胶片颗粒,边缘柔焦,像一张80年代的老照片,充满情绪感,高分辨率。
整理后的提示词(Prompt):
[Subject] A quiet child sitting on the old wooden floor, wearing a vintage knit sweater, playing with a simple toy, side profile, peaceful expression, [Environment] inside a nostalgic sun-drenched room, dusty atmosphere, peeling walls, vintage furniture in background, [Composition] medium shot, frame within a frame composition, viewed through a half-open weathered wooden door with peeling paint in the foreground, creating depth and privacy, [Lighting] soft diffused natural light, warm haze, floating dust motes, no harsh shadows, [Style] analog film photography, Kodak Portra 400 style, heavy film grain, faded sepia tones, nostalgic mood, slightly out of focus foreground, 1980s aesthetic, emotional, high resolution.
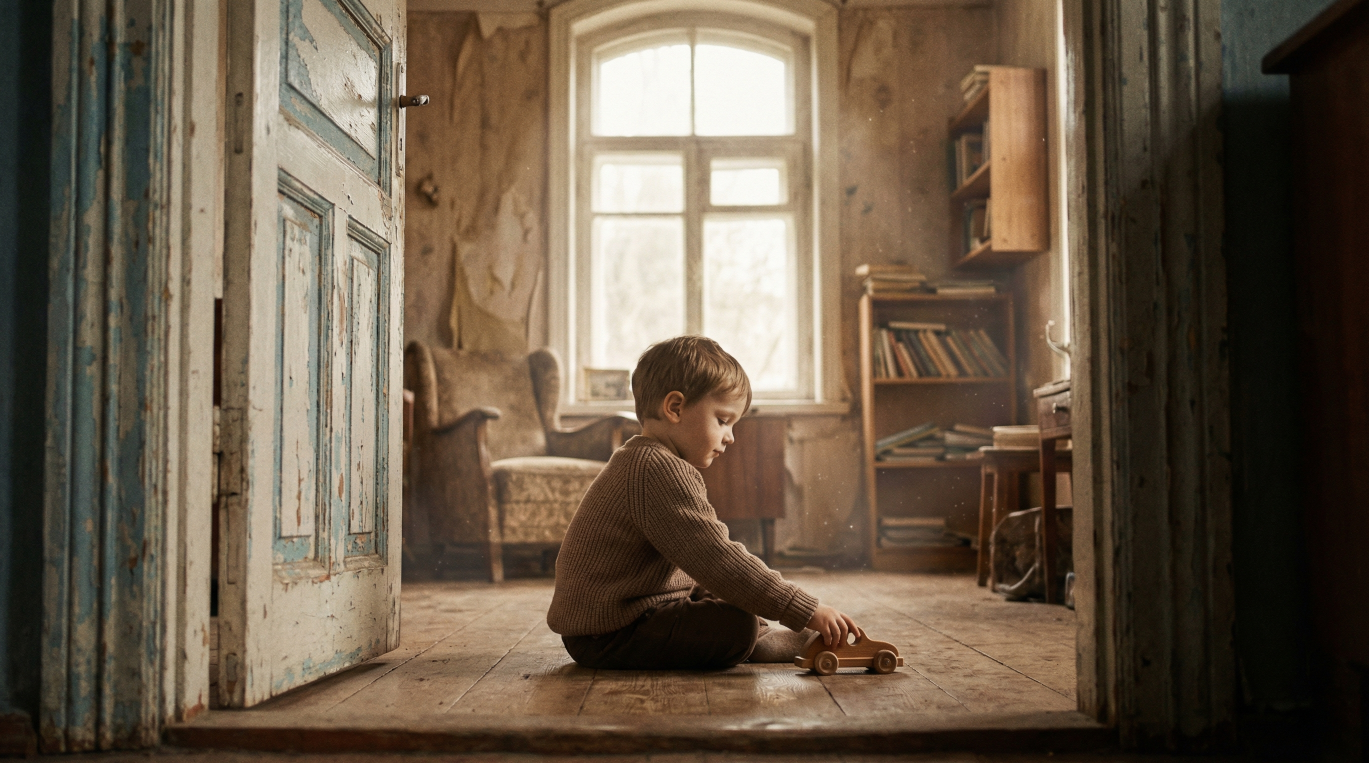 生成的图片
2.2 视频生成逻辑(修正版)
针对刚才那张“门框视角下的孩童”图片,我们需要通过拆解,构建一个稳固的视频结构。
视频核心公式: [主体运动] + [镜头运动] + [环境运动] + [氛围持续性]
我们可以这样拆解这张图:
主体运动 (Subject Action):拒绝“无效动作”
错误写法:
“小孩在玩积木。”
问题分析: 虽然AI能生成玩积木的画面,但动作往往是随机且平庸的。他可能只是拿着积木发呆,或者只是简单地摆弄,无法传达出你想要的“专注”和“小心翼翼”。
正确写法:我们要锁定具体的叙事动作。描述要具体到手指——
“小男孩屏住呼吸,手指捏着一块积木,极其缓慢地将其叠在另一块上,确认平衡后手才慢慢松开。”(通过描述微动作,强迫AI生成细腻的交互)。
镜头运动 (Camera Movement):利用“框架构图”
这张图有一个天然的绝佳构图——“门框”。这是一种窥视或回忆的视角。
运镜指令: Slow Dolly In(缓慢推近)。镜头从黑暗的门框外,缓慢向内推进,仿佛观察者的视线被这段回忆吸引进去,增加了沉浸感。
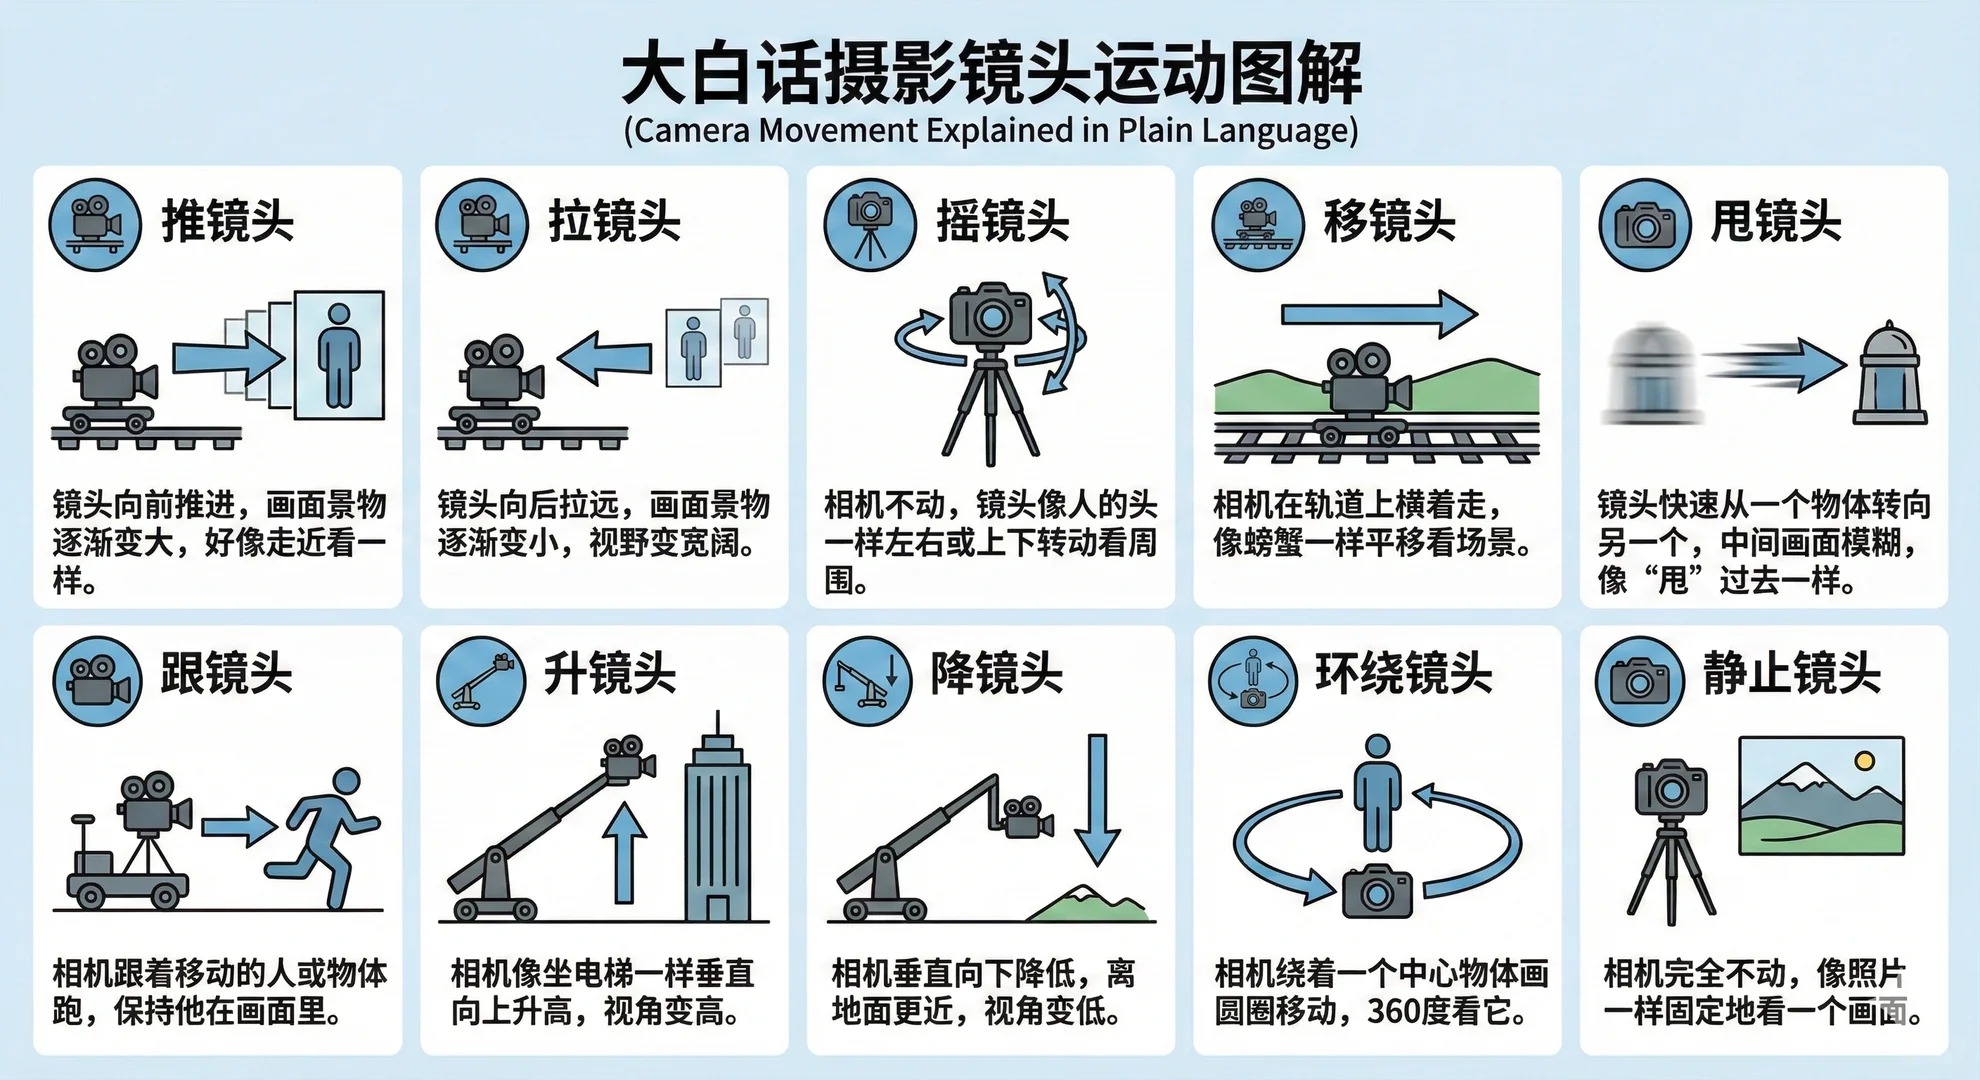
镜头运镜参考
环境运动 (Environment Motion):光影是灵魂
画面中最动人的不是家具,而是那束光。
环境指令: 阳光透过窗户射入,空气中的尘埃(dust motes)在光柱中缓缓游离。这种细腻的粒子运动,是让视频瞬间拥有“电影质感”的关键。
整理后的视频提示词 (Prompt):
(Subject) A toddler boy in vintage overalls sits on the wooden floor. He is holding a wooden block with extreme focus, slowly placing it on top of a stack, his hand trembling slightly with care. (Camera) View through a dark doorway frame, slow camera dolly in, pushing towards the child. (Environment) Warm sunlight streaming through the window, dust motes slowly floating in the shafts of light, quiet atmosphere. (Style) Nostalgic, cinematic lighting, 8k resolution.
第三阶段:精准校准——像导演一样“审片”
核心心法:正确的纠错方式是“对比”,而不是“否定”。
千万不要盲目相信AI,也不要因为第一次生成的不像就放弃。 很多人看到图跑偏了,反应是:“这画的什么垃圾,重来!” 然后点击 Re-roll(重新生成)。这是在买彩票,不是在创作。
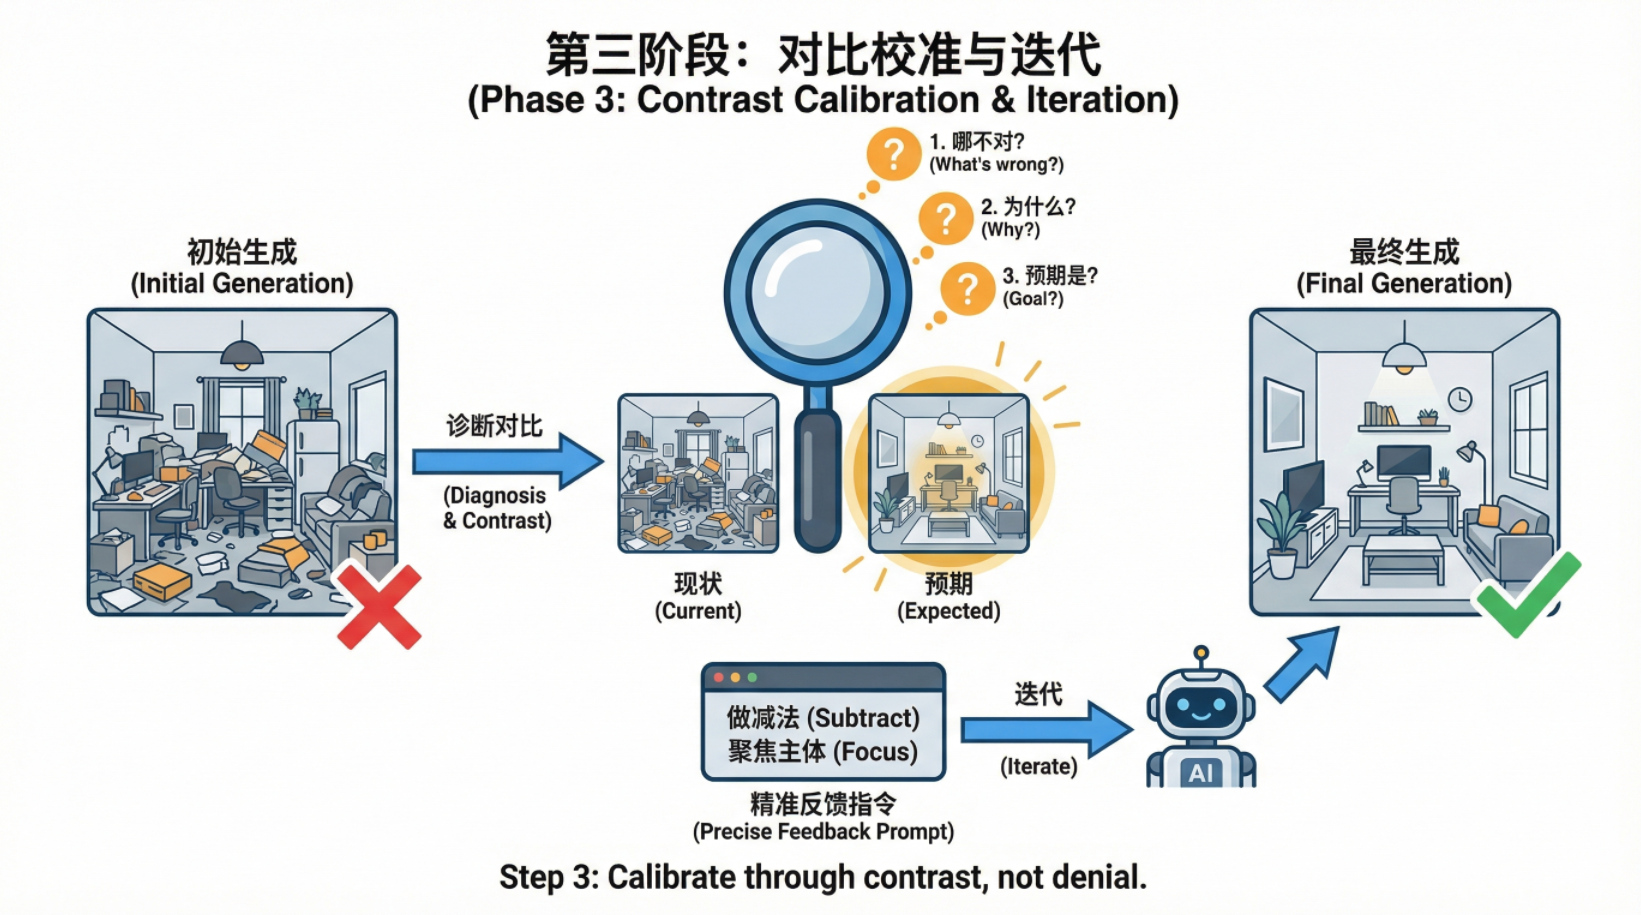
3.1 诊断三部曲
把生成出来的失败画面(或不够完美的画面)丢回给语言模型(Gemini),并告诉它:
哪一部分不对?(定位)
是情绪不对?(画面太阴暗了,像恐怖片)
是质感不对?(皮肤太光滑了,像假人)
为什么不对?(归因)
是因为光线太平了?(像影棚光,没有电影感)
是因为滤镜太重了?(磨皮过度)
目标预期是什么?(修正)
我要更真实的毛孔。
我要更明显的噪点。
3.2 实操案例:拯救“元素堆砌”的灾难现场
场景: 你想要生成一个“丰富、温馨的复古书房角落”。为了让画面不空洞,你在提示词里堆砌了大量名词:满墙的书、各种绿植、古董台灯、几只猫、毛毯、茶杯、地球仪……
结果: AI 生成了一张照片级的图像,每一个物体的材质都完美无瑕。但是!整个画面乱成了一锅粥。 书堆到了天花板快要塌下来,植物挡住了窗户的光线,地上全是杂物,你根本找不到重点在哪里。这是一张技术上满分,审美上不及格的照片,像是一个有囤积癖的人的房间。
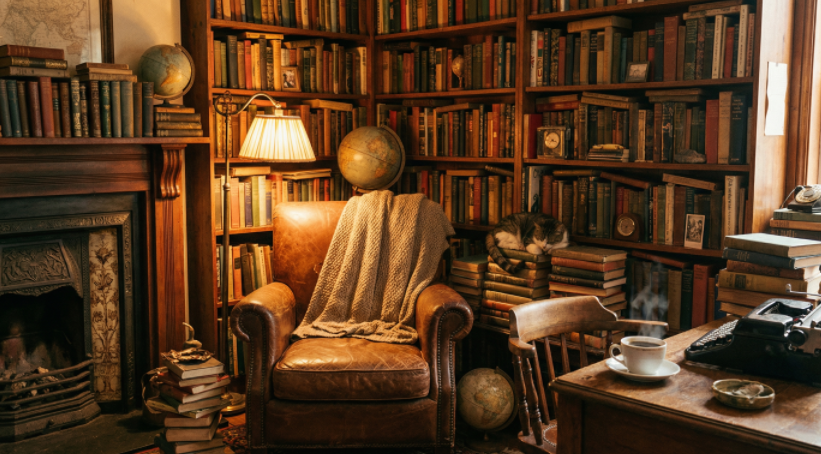
错误修正: “太乱了,整洁一点。”(AI可能会把所有东西都移走,变成样板房,失去了温馨感。)
正确修正(使用对比法+做减法): 把这张图丢回给 AI,进行诊断:
哪一部分不对?(定位)
构图没有重心,眼睛不知道看哪里。
为什么不对?(归因)
因为所有元素都在抢戏(Competing elements)。物体密度过大,没有留白(Negative space)。
目标预期是什么?(修正——做减法)
我要建立视觉层级(Visual Hierarchy)。
只保留一个主角(那把皮沙发和阅读灯)。
其他的元素(书墙、植物)必须后退,变成背景虚化(Background Bokeh)。
重新整理的提示词:
直接进行图生图
A focused shot of a single worn leather armchair and a lit vintage floor lamp. (主角). A cat sleeping on the armchair. The background is a slightly blurred wall of bookshelves and plants, providing a cozy atmosphere but not distracting from the chair. (背景). Minimalist composition, warm light.
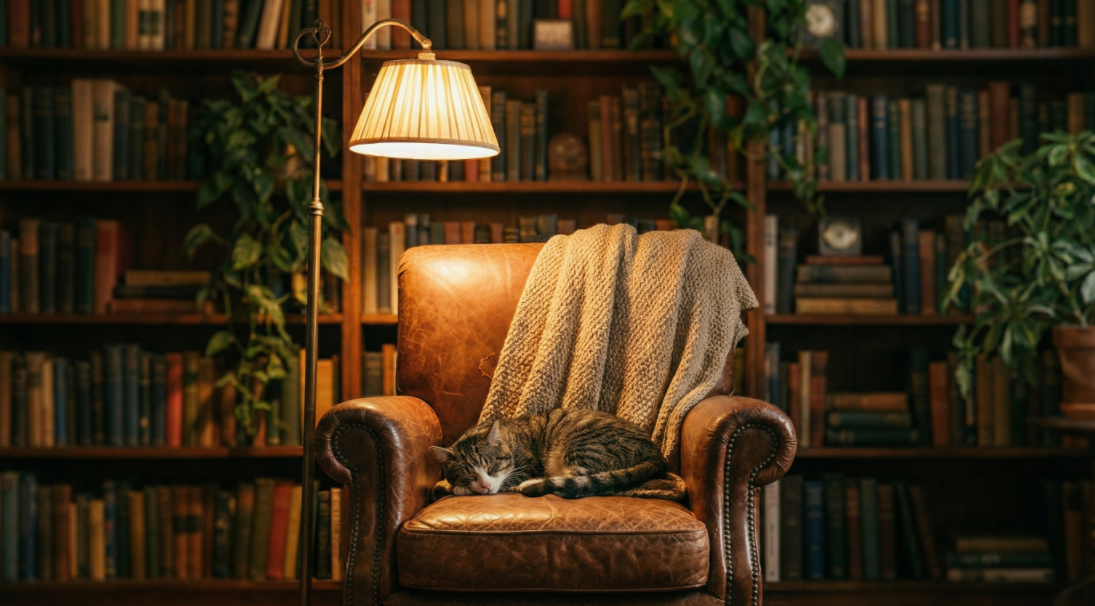
瞬间质变: 画面从“杂货铺”变成了“高级杂志内页”。
核心逻辑: 2026 年的 AI,能力是溢出的。你不需要教它如何添加细节,你需要学会如何抑制它过度表现的冲动。学会控制“留白”,才是高手的标志。
结语
学会了这三步:
让AI问你(获取细节)
整理逻辑(匹配工具)
对比校准(精准迭代)
你会发现,画面不再是靠运气“抽”出来的,而是被你一步步“构建”出来的。这时候,AI就不再是一个冷冰冰的工具,它是你手中的笔,是你脑海中画面的最佳翻译官。
提示词结构执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课的重点不是堆形容词,而是围绕「告别“抽卡”玄学:三步法让AI精准复刻你脑中的画面」把提示词写成能执行、能复用、能检查的结构。
按原文节奏走最稳:先吃透「第一阶段:反客为主——让AI来“采访”你」,再把「第二阶段:逻辑重组——把问答碎片变成“可执行代码”」定住,接着处理「第三阶段:精准校准——像导演一样“审片”」;最后用「结语」收口。
- 先把「第一阶段:反客为主——让AI来“采访”你」里的变量写全。
- 这一段别堆词,先把作用分清。
- 做完「第三阶段:精准校准——像导演一样“审片”」后,把可复用句子留下。
- 先把「结语」里的变量写全。
不要只堆形容词;提示词要写清主体、场景、镜头、光线、动作、限制条件和验收标准。
检查提示词是否有清晰主体;是否说明画面关系;是否有可执行动作;是否包含避免跑偏的限制条件。
请围绕「告别“抽卡”玄学:三步法让AI精准复刻你脑中的画面」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:提示词结构拆解、中文提示词、英文提示词、负面限制词、生成后修改建议和自检清单。要求每个词都有明确作用。